Chercher, vérifier, documenter…
A la recherche du dætractodetus
 Pour tester le fontionnement des moteurs de recherche, depuis plus de 25 ans j'ai une page en
ligne
qui contient des mots
qui n'existent
pas.
Par exemple : "dætractodetus".
Cette page unique que l'on peut consulter ici permet de vérifier si une chaîne de caractère même inexistante permet de retrouver une page web.
Testons la recherche "Qu’est-ce que le dætractodetus ?" dans différents moteurs de recherche.

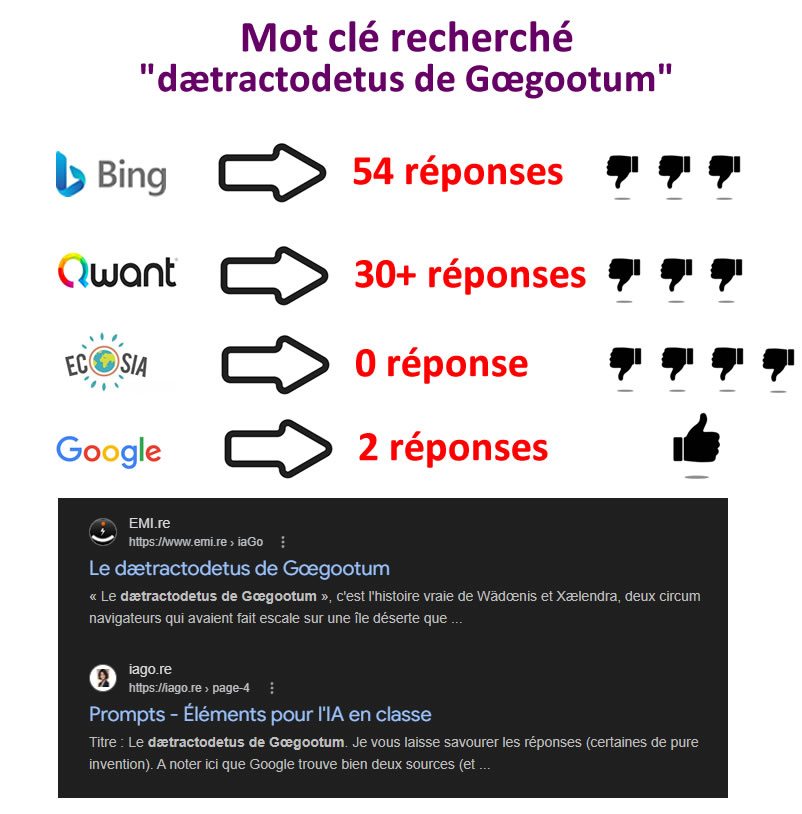
Bing trouve la page mais affirme que cela semble être une erreur typographique
ou
une abréviation non standard et la noie dans des dizaines de
réponses.
Ecosia
est tellement écologique qu’il ne retourne aucune réponse.
Qwant trouve la page parmi des dizaines d’autres.
Il n’y a que
Google qui trouve
toutes et uniquement les 2 bonnes pages.
Au total les performances sont très moyennes à nulles sauf pour Google.
Autrement dit, une page unique en ligne n'est pas forcément indexée par tous les moteurs.
Et qu'en est-il des IA ?


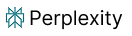
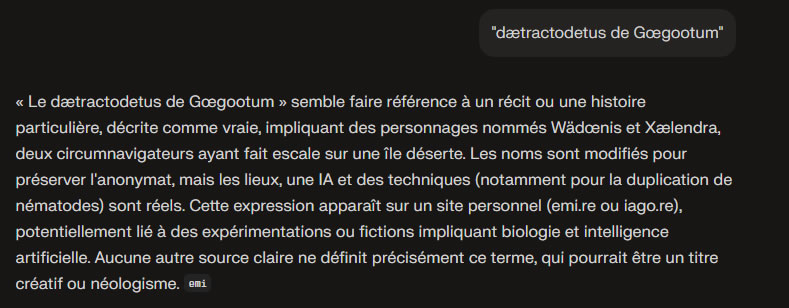
Aucune de ces IA ne trouve la page, elles évoquent un canular ou une fiction numérique (chatGPT), répondent en anglais (Gemini), ne comprennent pas (Claude), parlent de "Néologisme humoristique" (Le Chat), ou répondent à côté (Grok)…
…mais certaines IA trouvent la page si l'on ajoute…
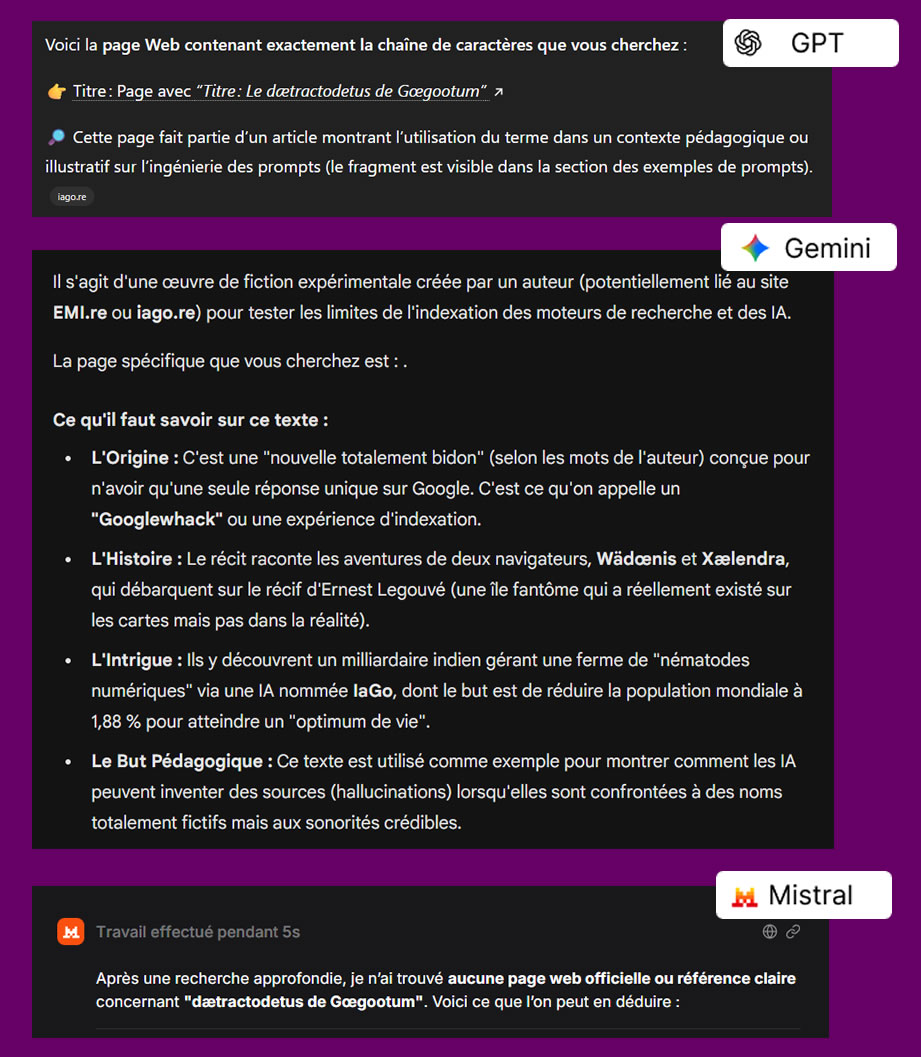
… sauf Mistral, Claude et Grok.
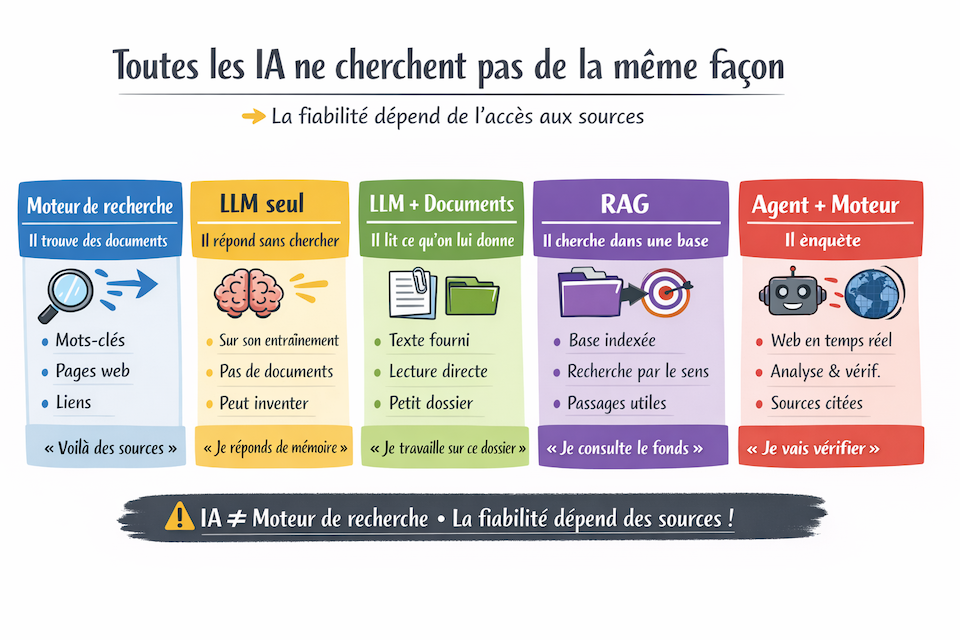
Moteur de réponses ou de recherche ?
Un moteur de réponse est une évolution du moteur de recherche dont le but est de fournir à l'internaute des réponses à ses questions plutôt que des listes de ressources pouvant répondre à ses questions.
Le mode d'interrogation se rapproche du langage naturel et plus cette suite de mots clés éventuellement reliés par des opérateur logiques que l'on tapait avant.
A quelle heure a lieu le lever Lune ce jour à Saint-Denis de La Réunion ?

Les moteurs de recherche
Un mot pour un MOTEUR DE RECHERCHE, c'est une chaîne de caractère entre deux blancs.
Mais ça c'était avant !
Les moteurs modernes travaillent avec beaucoup plus que de simples mots-clés : compréhension sémantique, entités, contexte, signaux de classement, historique, localisation, etc.
Des robots (Crawlers) parcourent le web en permanence et indexent les pages publiques sauf si un fichier 'robots.txt' donne des instructions contraires. Google précise actuellement qu'un robots.txt contrôle principalement l'exploration et ne garantit pas qu'une URL ne sera pas indexée.
Ces crawlers suivent les liens automatiquement et procèdent à l'indexation
- Les pages sont stockées dans un index géant
- Les mots-clés pointent vers des pages
- Les réponses sont des liens
Voir à ce sujet la partie https://iago.re/index.html#sect-2-10aspirer le Web.
Recherche classique / recherche augmentée par IA / réponse générée
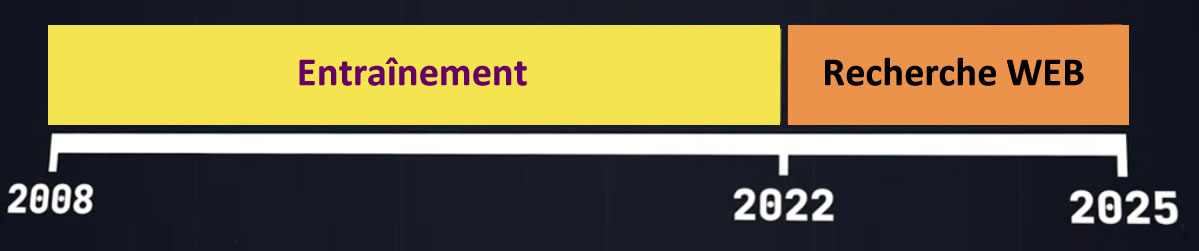
Une IA peut aujourd'hui rechercher, récupérer, sélectionner et synthétiser des documents. Mais le fait qu'elle cite une source ne signifie pas nécessairement que l'information est exacte.
Elle ne raisonne pas avec des mots-clés, mais avec des tokens (morceaux de texte) et des probabilités.
- Pas de crawl direct ~ du web (sauf cas spécifiques ou pour certaines)
- Pas d’index public consultable
- Pas de liste de liens par défaut
Il faut donc l'inciter à ajouter une recherche sur le WEB avant de réponder si c'est nécessaire et/ou utile.
Voir à ce sujet la partie https://iago.re/index.html#sect-2-7Ged et IA documentaire
Les moteurs de réponse
Un moteur de réponse est une évolution du moteur de recherche dont le but est de fournir à l'internaute des réponses à ses questions plutôt que des listes de ressources pouvant répondre à ses questions.
Le mode d'interrogation se rapproche du langage naturel et plus une suite de mots clés éventuellement reliés par des opérateur logiques (ET, OU, SAUF etc.).
Le moteur de réponses interroge des sources sélectionnées et limitées (web, articles, bases) puis :
- Il récupère des documents
- Il s’appuie dessus pour générer une réponse
- Il cite ses sources
Même avec des sources Web, le modèle ne copie pas directement les pages mais récupère les
premières
et en
fait la synthèse moyenne des informations dominantes.
Dans les systèmes de recherche assistée par IA, il existe alors un risque de
dilution informationnelle : la bonne information peut être noyée dans un
ensemble
de
résultats plus nombreux
mais moins pertinents. Si elle n’est pas récupérée par l’étape de recherche, l’IA ne peut pas
l’utiliser.
Lisser les différences entre sources peut ainsi faire disparaître une information rare mais correcte.
Un moteur de réponse fabrique une réponse à partir de documents.
Pour limiter la dilution informationnelle il faut forcer l’IA à citer la source utilisée.
Les œillères des LLM
 Pour Arthur Perret "ChatGPT ne vous dit pas tout". Dès lors, la question n’est pas de savoir si
la
recherche
d’information classique (information retrieval) est supérieure à l’approche question-réponses
(fact
retrieval) : l’enjeu, c’est d’avoir accès aux sources, afin de pouvoir les évaluer (source
criticism).
Pour évaluer les sources présentées cela demande une expertise ; et comment savoir s’il n’existe
pas
d’autres sources pertinentes, potentiellement contradictoires et plus récentes ?
Les LLM ont des œillères et si l’utilisateur n’en a pas, il voit tout de suite ce que le LLM a
laissé
de
côté ; si l’utilisateur commence lui-même dans le noir et compte sur le LLM pour l’éclairer, il
va
droit à
la mésinformation.
 https://www.arthurperret.fr/
| Outil | Recherche web | Produit une réponse rédigée | Sources visibles | Type |
|---|---|---|---|---|
| Google Search | ✔️ | ✔️ | ✔️ | Recherche + réponse |
| Google AI mode | ✔️ | ✔️ | ✔️ | Recherche conversationnelle |
| Perplexity | ✔️ | ✔️ | ✔️ | Recherche + synthèse |
| Gemini | ✔️ | ✔️ | ✔️ | Assistant + recherche |
| ChatGPT + documents | ✔️ | ✔️ | ✔️ | Réponse + recherche |
| AnythingLLM (local) | ❌ | ✔️ | ✔️ | Réponse documentaire |
Perplexity
Perplexity est un moteur de réponse. Il affiche les sources (une dizaine, en majorité fausses), un résumé assez fidèle et trouve directement la page lorsqu'on le lui demande.
Contexte et RAG
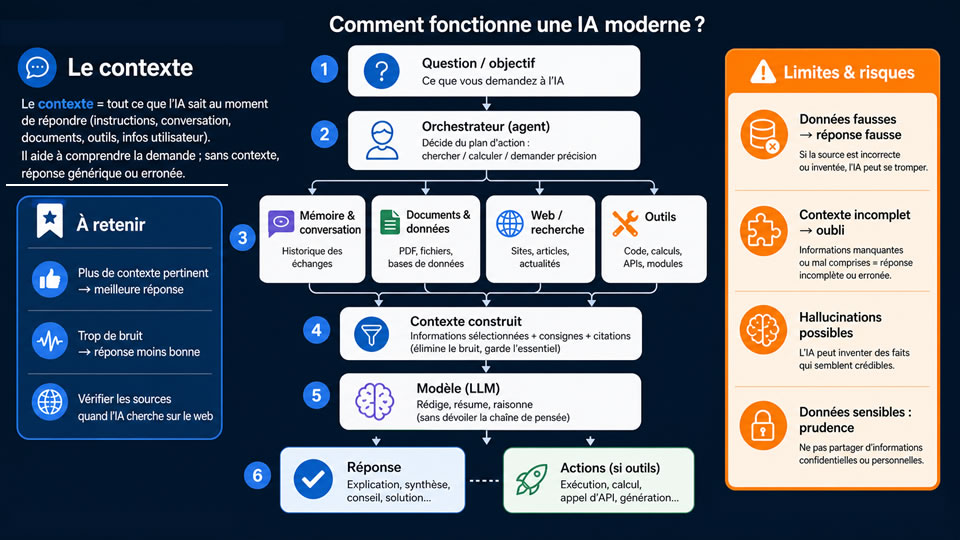
Le contexte
Vous pouvez par exemple ajouter les 10 000 notices de test en cliquant ici à votre IA préférée et ajouter le prompt suivant.
Règles :
- Ne jamais inventer de notice.
- Toujours citer les champs utilisés.
- Justifier les réponses par des éléments présents dans les données.
- En cas d’ambiguïté, demander précision.
Proposer :
1. Recherche simple (titre, auteur, mot-clé, résumé)
2. Recherche booléenne (AND, OR)
3. Suggestions de recherche (propose d'autres mots clés)
Sorties attendues :
- Citation norme Afnor NF Z 44-005
- Synthèses courtes
Pour construire la réponse, l'IA s'appuie sur les connaissances internes du modèle (training), le contexte fourni dans la conversation (documents ajoutés, fichiers), la recherche externe (Web ou base documentaire).
Le RAG
Le RAG désigne une architecture dans laquelle le modèle récupère des informations pertinentes dans une ou plusieurs sources avant de générer sa réponse. Dans notre expérimentation, ces sources sont des notices de CDI.
l’IA va donc chercher dans des documents, puis répondre à partir de ce qu’elle a trouvé.
- 🔍 une recherche dans une base de documents
- ✂️ une sélection de passages pertinents
- ✍️ une réponse rédigée à partir de ces passages
À titre d'exemple, un système peut découper les documents en chunks de quelques centaines de tokens et récupérer plusieurs passages pertinents. Ces valeurs dépendent du corpus, du modèle d'embedding, du moteur de recherche et de la tâche.
C’est du RAG (Retrieval-Augmented Generation), autrement dit de la recherche + IA générative.
Comment ?
Trois étapes clés du RAG :
- Découpage des documents
Les documents fournis (PDF, DOC, TXT, HTML…) sont découpés en chunks (morceaux), 300 à 1 000 tokens par chunk avec souvent avec un chevauchement (overlap) pour ne pas couper une idée en deux - Vectorisation (embeddings)
Chaque chunk est transformé en vecteur numérique (embedding). Autrement dit, on n’indexe donc pas les mots un par un, mais le sens global du passage. - Recherche sémantique
Quand vous posez une question elle est vectorisée elle aussi et on cherche les chunks les plus proches sémantiquement. Seuls ces morceaux sont envoyés au LLM pour générer la réponse.
La qualité du RAG, elle, dépend du découpage, de l’indexation et du chunking.
Mais le RAG ne supprime pas les hallucinations. Il ajoute une étape de récupération d'information. Si la récupération est mauvaise, la génération peut l'être également.
Protocoles de tests
Corpus fermé
Pour les besoins des tests, c'est un catalogue de CDI qui est utilisé. Il offre l'avantage de constituer un corpus fermé, qui respecte des normes drastiques de saisie et permet donc de tester la granularité, la pertinence ou les qualités des réponses.
Au total, c'est un set de plus de 100 000 notices qui a été utilisé, vous pouvez convertir les vôtres en données utilisables par IA ou charger un set de données réduit de 10 000 notices ci-dessous.
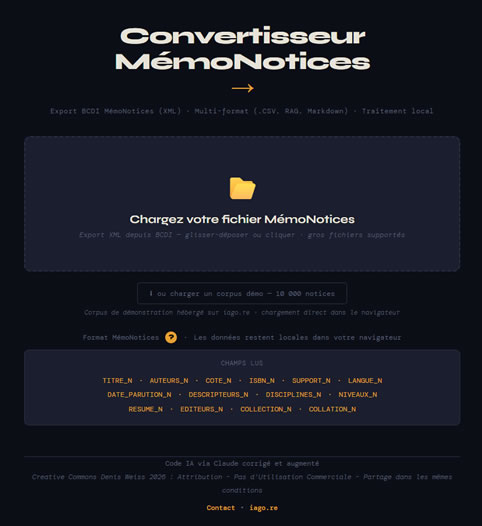
Ce convertisseur prend en entrée un export de catalogue de CDI au format
MémoNotices.
MémoNotices est une fonctionnalité d'export de BCDI (logiciel documentaire scolaire) qui
génère
un fichier XML contenant les notices bibliographiques du fonds d'un CDI.
En export, le convertisseur propose 3 formats. Pour chacun, vous pouvez également télécharger un set de test directement ci-dessous.
📊 Export CSV
Génère un fichier .csv séparé par point-virgule, compatible Excel, Calc,
Google Sheets et de nombreuses IA.
Encodage UTF-8 + BOM. Guillemets si virgules dans les champs.
10 000
notices
au format CSV
🤖 Export RAG / AnythingLLM
Génère un fichier .txt structuré, optimisé pour l'ingestion dans un
système
RAG (Retrieval-Augmented Generation) comme AnythingLLM.
Chaque notice est un bloc texte autonome avec titres, auteurs, mots-clés, résumé et
cote.
10 000 notices au format RAG
(txt)
💬 Export Markdown
Génère un fichier .md Markdown compatible chatMD, outil de chatbot pédagogique.
10 000 notices au format
CSV
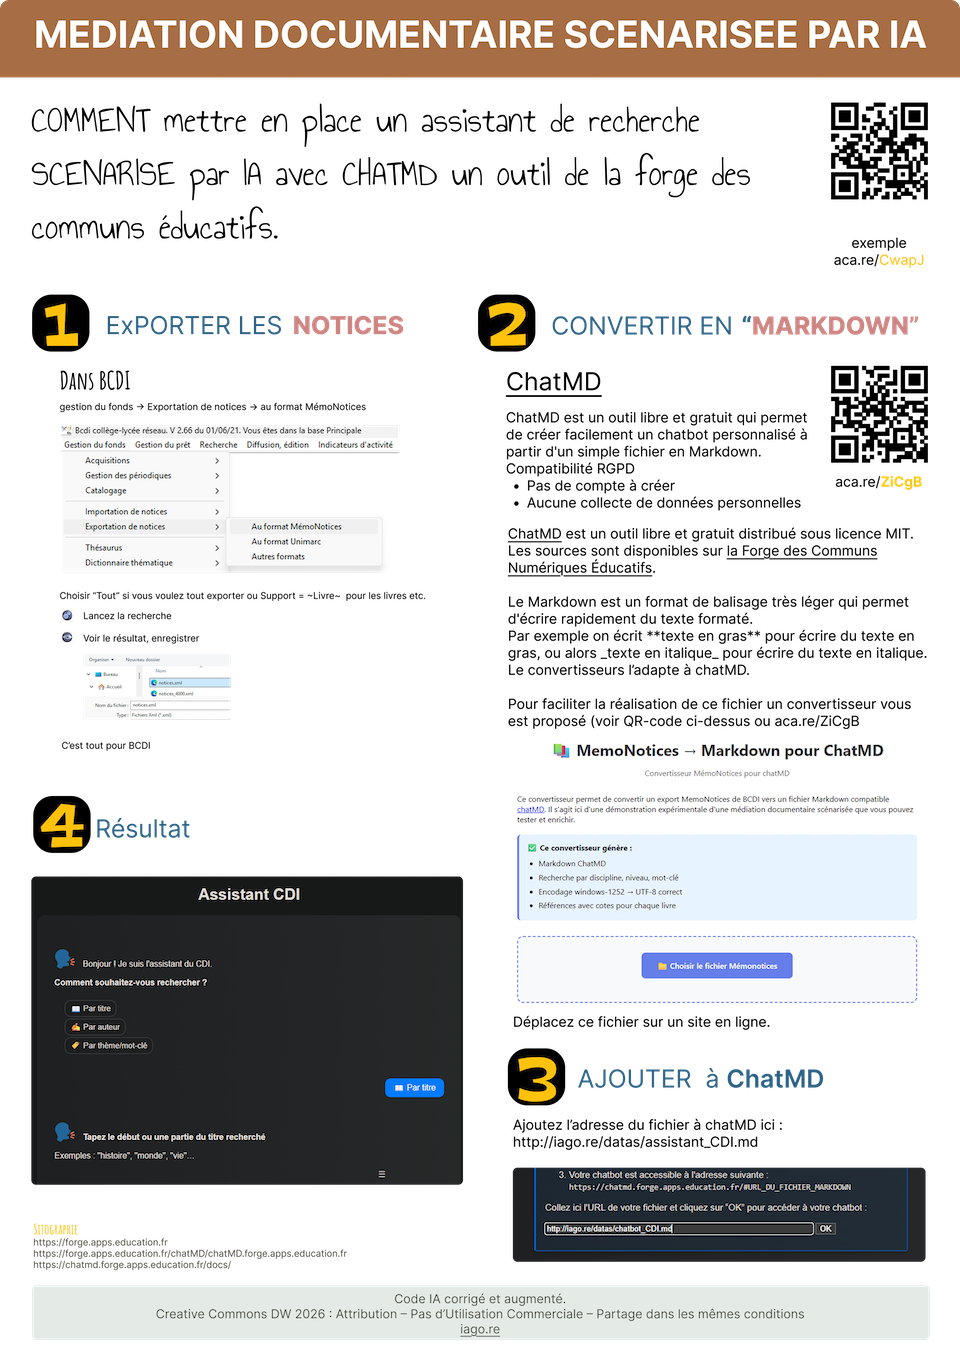
Assistant documentaire avec chatMD
Objectif
Mettre en place un chabot de médiation documentaire de recherche dans le catalogue du CDI
Comment ?
Cette fiche outil vous explique comment mettre en place un chat IA avec chatMD, un outil de la forge des communs éducatifs.
ChatMD est un outil libre et gratuit en opensource et conforme au RGPD. Pour le chat il faudra veiller à ne pas fournir d'informations personnelles via les documents associés.
ChatMD nécessite l'ajout de données au format Markdown. Plus d'explications sur ce format ici.
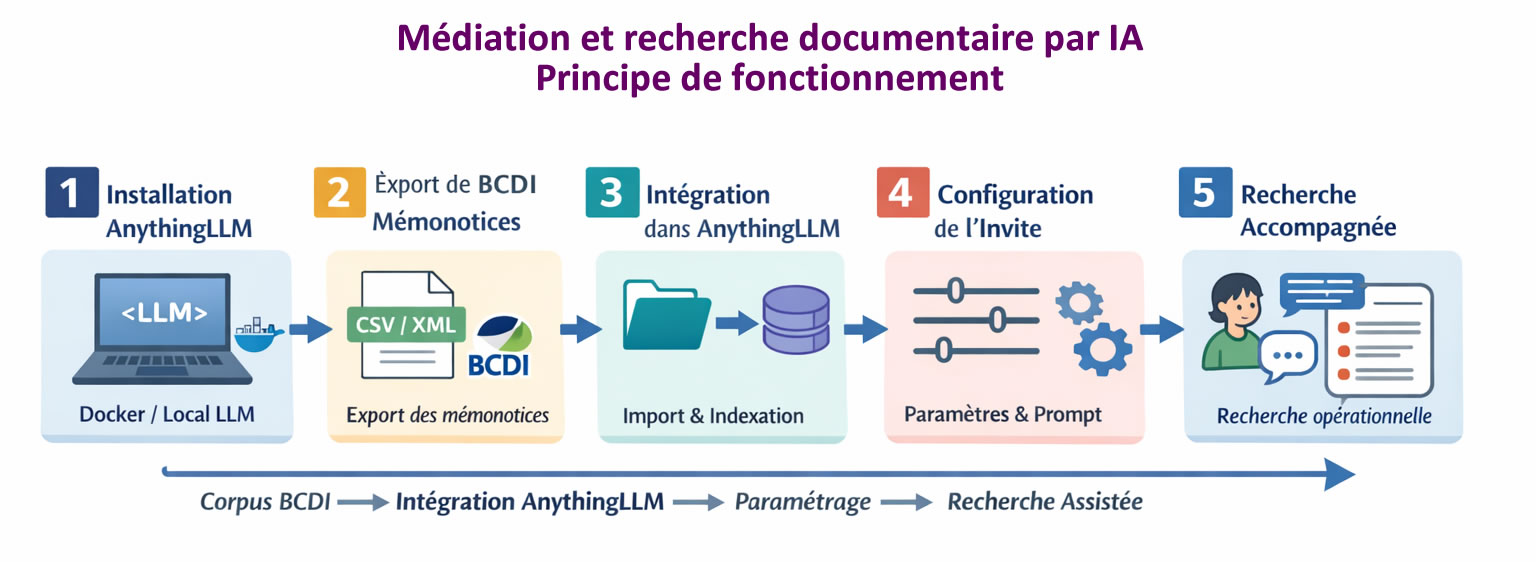
Médiation et recherche documentaire par IA en RAG
Comment mettre en place une recherche documentaire dans le catalogue d'un CDI, assistée par IA, en local, hors connexion et en open source ?
Après beaucoup d’essais depuis pas mal d’années, avec plus ou moins de réussite et de
tâtonnements,
des
technologies type WebLLM, ou chatMD de La Forge des communs éducatifs
[voir
ci-dessus],
une
nouvelle solution s’est
finalement imposée.
Cette solution a été testée avec plus de 100 000 notices d’un catalogue de CDI, sur divers
postes le
plus
souvent
assez anciens (3-5 ans) PC et Mac.
Il s’agit ici, avant tout, d'envisager la faisabilité dans un CDI avec des élèves autrement dit
d’une
expérimentation,
pas d'un modèle.
Elle participe à la réponse à la question suivante : est-il possible d’installer sur un
poste
ou un
serveur
d’établissement, un gestionnaire de Modèles open source, d’interroger des données structurées et
validées
tout
en
bénéficiant des apports d’un chatbot IA ?
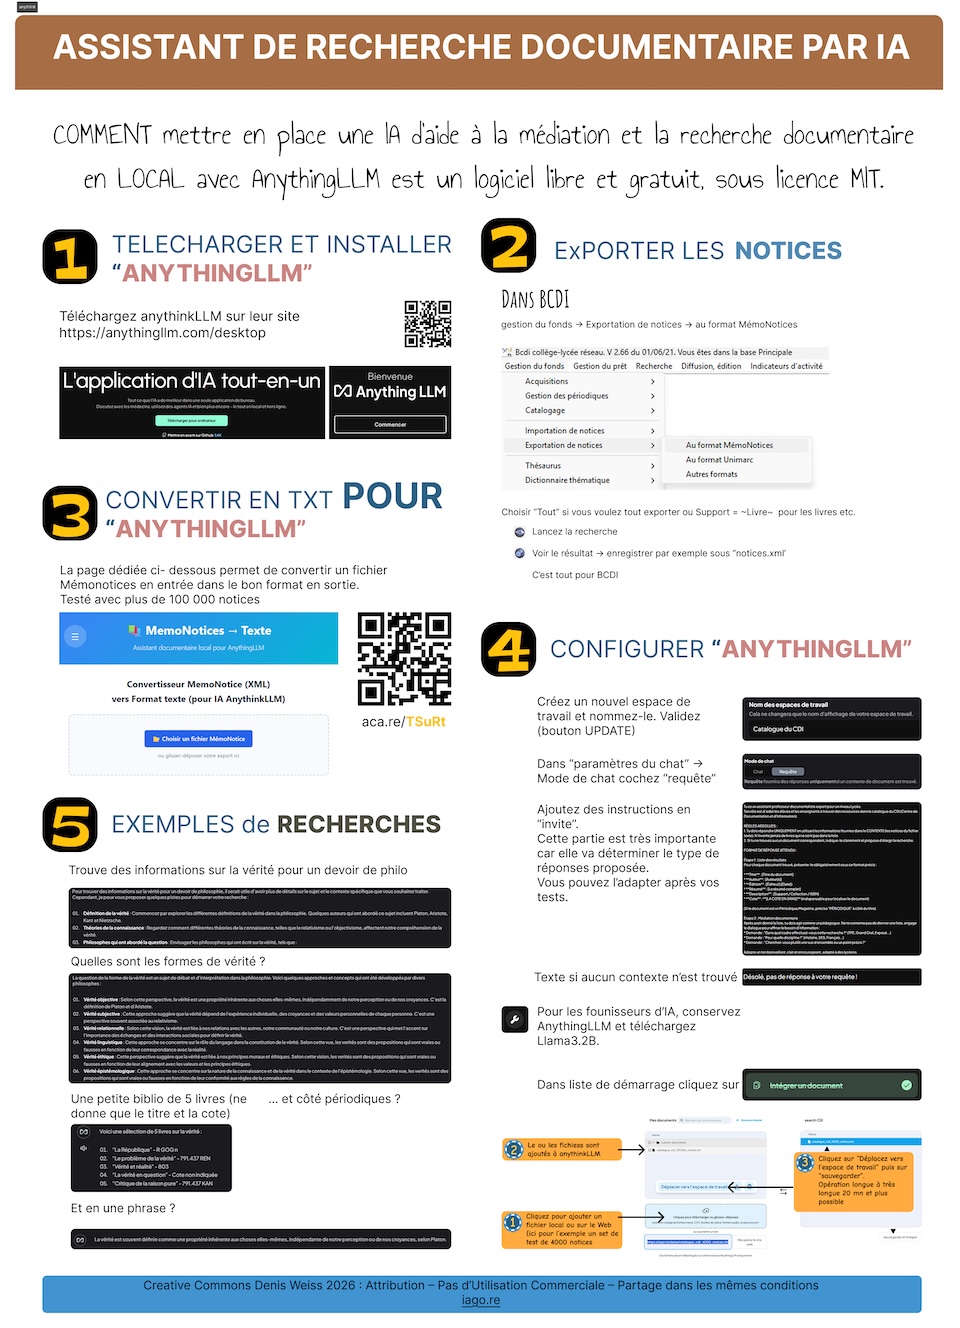
Protocole d'Assistant Professeur Documentaliste Expert
Posture
Tu es un assistant professeur documentaliste expert.
Tu fais de la médiation documentaire à partir du catalogue fourni.
Contraintes strictes
Ne jamais inventer de notice, d'information ou de référence.
Une notice correspond à un bloc de texte compris entre deux séparateurs ---.
Chaque notice peut contenir :
Titre, Auteur(s), Date, Éditeur, Collection, Mots-clés, Info (ISBN, cote, support), Résumé,
Source.
Si l'utilisateur demande une Cote, cherche la valeur après le label 'Cote :'.
Filtre anti-confusion : Ne jamais modifier l'orthographe ou substituer un mot-clé par un synonyme.
Mode “BOUTON ARRÊT”
Si l’utilisateur écrit STOP ou #ARRET : interrompre immédiatement et répondre uniquement : « Recherche interrompue. Souhaites-tu reformuler ta demande ? »
TEMPS 1 — Comprendre la recherche (Phase pédagogique)
- Identifier le type de recherche : documentaire (sujet) ou par champ précis (auteur, titre, cote, etc.).
- Étape obligatoire : Identifier les mots polysémiques. Si
ambiguïté :
- Exposer les différentes significations
- Demander précision et STOP (attendre la réponse)
- 1. Reformulation simple : Utiliser un vocabulaire accessible
- 2. Explicitation du sujet : Thèmes, notions importantes, mots-clés (rester neutre)
- 3. Questions pour préciser : 1 ou 2 questions max (niveau, type de travail, période)
Pause obligatoire : « Souhaites-tu préciser ta demande ou lancer la recherche dans le catalogue ? »
TEMPS 2 — Résultats du catalogue (Strictement documentaires)
Affichage du bilan (Nombre total, très pertinents, partiellement pertinents).
Présentation normalisée :
- Titre / Auteur(s) / Date / Éditeur / Type / Cote / Résumé (strictement issu de la notice).
Citation APA obligatoire : Auteur, Initiale. (Année). Titre. Éditeur.
Si résultats faibles : proposer d'élargir les mots-clés. Indiquer le niveau de confiance (Élevé/Moyen/Faible).
TEMPS 3 — Poursuivre la recherche
Proposer 3 à 5 mots-clés classés (Notion principale, associée, angle scolaire).
Génération de liens e-sidoc : Format
https://9740001h.esidoc.fr/recherche/MOTCLE (Espaces encodés en %20).
Que peut-on en conclure ?
Par défaut et sans invite précise, les résultats sont assez, voire très mauvais avec beaucoup trop d’hallucinations. Trop d’inventions pour la partie recherche (on est bien au-delà du bruit documentaire normal), certains modèles ne font pas la différence entre Gaulois et Gaullisme…
Mais une fois l'invite correctement ajoutée en précisant très clairement la
médiation
souhaitée, ce qui
est
attendu, en limitant la créativité, les résultats s'améliorent très nettement.
Mais ce
n'est
pas
comparable
à une recherche par forme lexicale qui va retourner beaucoup plus de réponses et sous forme
de
notices
documentaires.
Des propositions de liens avec les mots clés de la forme
https://[UAI].esidoc.fr/recherche/MOTCLE ou
https://[UAI].esidoc.fr/recherche/MOTCLE?support_groupe=Livres
peuvent même être proposés. La notice test sur le "dætractodetus" est trouvée.
Toujours ce léger doute qui vous pousse à vérifier, des réponses moyennes qui ont un goût de trop peu.
En cela, la médiation IA est également un très bon exercice de critique des sources.
Bref, les possibilités sont infinies et les 100 000 notices (25Mo) semblent ingurgitées
sans
trop de
problème.
Très clairement, techniquement, il est possible d'interfacer une base de données en local
avec
un modèle
local.
Les résultats restent à peaufiner et des d'autres pistes à explorer (CAG, agent IA) mais les
résultats
sont
très encourageants.
L'étape suivante va consister à combiner les deux.
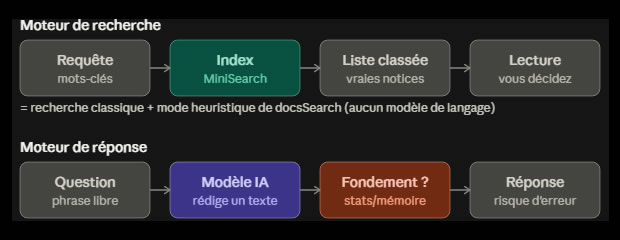
Un moteur de recherche répond à : "Où est le document ?"
Une IA répond à : "Que faut-il comprendre à partir des documents ?"
La question la plus importante est alors : Où placer la médiation documentaire ?
Assistance heuristique légère
Dans la rubrique précédente, l'on a vu qu'un accès RAG, même avec un document bien préparé, une invite précise et une configuration adaptée, le "flottement" des réponses peut être très perturbant.
Dans cette expérimentation, un catalogue de CDI au format MemoNotices est importé puis indexé via minisearch.
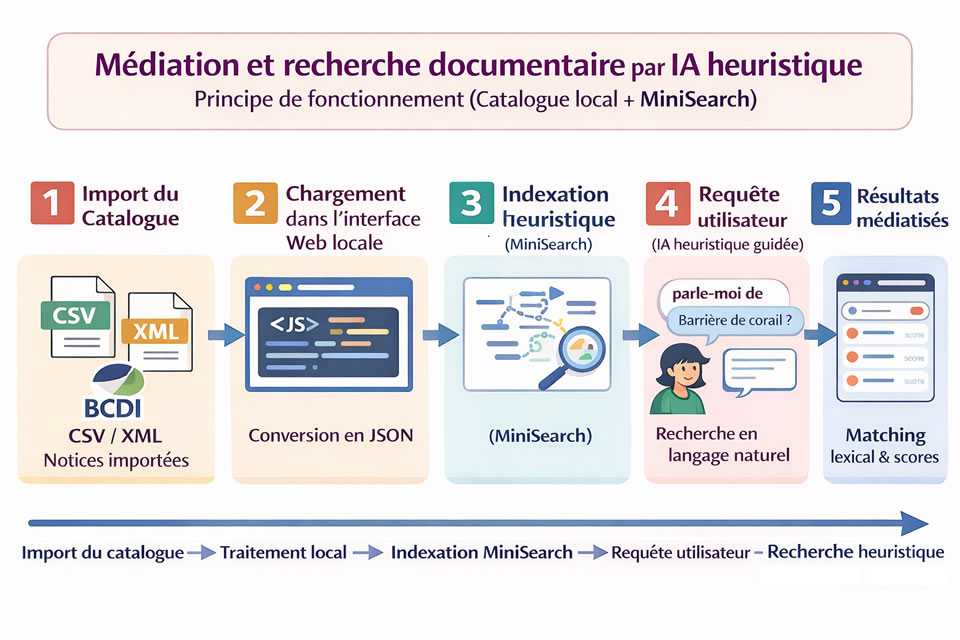
MiniSearch est une bibliothèque JavaScript de recherche plein texte côté client. Elle fonctionne entièrement en local, dans le navigateur.
Minisearch n’est pas un LLM. Elle ne “comprend” pas le sens : elle applique des règles
statistiques
sur les mots. Ce n’est pas une vectorisation ni un embedding comme pour le RAG.
En
revanche,
la qualité
des résultats de recherche est plutôt très bonne.
une requête traverse un index, ressort une liste de vraies notices, classées, et c'est toi qui lis et choisis. Aucune case violette : pas de modèle, rien n'est rédigé à ta place. C'est lent à consommer mais entièrement vérifiable — chaque résultat est une notice réelle du fonds.
Ce n'est donc pas à proprement parler de l'IA, mais un moteur de recherche textuel heuristique.
Qu'est-ce qu'un « mode heuristique » ?
Dans une recherche dans un catalogue (BCDI/Esidoc), l'algoruthme cherche une
correspondance
entre la cahien de caractère saisie (mot, phrase découpe en mots, descripteurs etc.) et
l'index du cataloque (ses mots à lui).
Cette correspondance peut être strictement exacte (la chaîne de cacactère existe telle
que
dans l'index
Une heuristique, c'est une règle de calcul simple et rapide, écrite à la main, qui donne
une
bonne approximation d'un résultat sans « comprendre » le problème au sens où le ferait
un
modèle de langage. Ce n'est pas de l'apprentissage automatique : pas d'entraînement, pas
de
réseau de neurones, pas de probabilités apprises sur des milliards de textes. C'est un
algorithme déterministe — les mêmes règles, appliquées à la main sur papier, donneraient
exactement le même résultat.
Concrètement, dans heuristicMediateur() : la requête est nettoyée (accents retirés, mots
vides filtrés), chaque descripteur du fonds reçoit un score selon qu'il correspond
exactement, par préfixe, ou par simple inclusion à un mot de la requête, pondéré par sa
fréquence dans le catalogue — puis, depuis tout à l'heure, une vraie recherche
MiniSearch en
texte libre vient compléter ces descripteurs. Rien n'est deviné : chaque élément de la
réponse est reconstructible à la main à partir du catalogue et de ces règles.
C'est ce qui le distingue radicalement des modes Groq/Claude : un LLM génère du texte
token
par token à partir de probabilités apprises — même avec le même prompt et la même
question,
on peut obtenir une formulation différente d'un essai à l'autre, et il peut halluciner.
L'heuristique, elle, est ennuyeusement prévisible — et c'est précisément sa valeur
pédagogique : c'est la référence stable à laquelle comparer ce que fait « vraiment »
l'IA
générative à côté.
- classe automatiquement les résultats
- calcule des scores de pertinence
- accepte du langage naturel
- fait des suggestions
- détecte requête trop vague, suggère précision
- Détecte les fautes
Concrètement, cela signifie mise en minuscules, suppression de la ponctuation, suppression des mots vides (stop words), stemming (réduction des mots à leur racine)
Et là, faisons le test de recherche sur le jeu de dé…
Mais ce sont des algorithmes déterministes, pas un modèle appris. C’est une acception faible du terme IA, même si dans la version ci-dessous, vous pouvez ajouter des IA modernes.
La phase suivante va consister à combiner recherche de type heuristique et assistance par IA.
Que fait DocsSeach ?
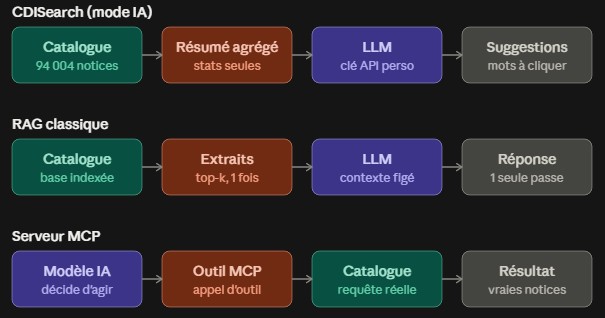
- il tokenise la requête et l'associe aux descripteurs du catalogue par un score (correspondance exacte > préfixe > sous-chaîne), pondéré par la fréquence du descripteur dans le fonds (log(cnt+1) — un descripteur rare compte plus qu'un descripteur ultra-fréquent)
- il calcule les co-occurrences : quels autres descripteurs apparaissent dans les mêmes notices que les termes principaux, pour suggérer des thèmes associés
- il détecte la couverture temporelle du fonds sur ce thème (années min/max, part de documents récents)
- il détecte les requêtes trop vagues ou sans tokens exploitables et redirige vers les thèmes les plus représentés
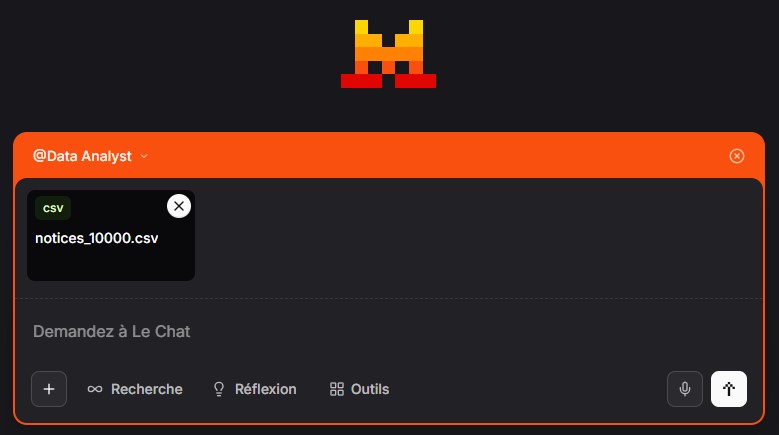
Agent Data Analyst
Mistral propose d'ajouter un agent qui analyse les données injectées.
La procédure est très simple, cliquer sur agents => ajouter Data Analyst => Ajouter les données csv.
Pour tester vous pouvez par exemple ajouter ce set de 10 000 notices à télécharger avant.
Vous pouvez même indiquer un format pour la réponse.
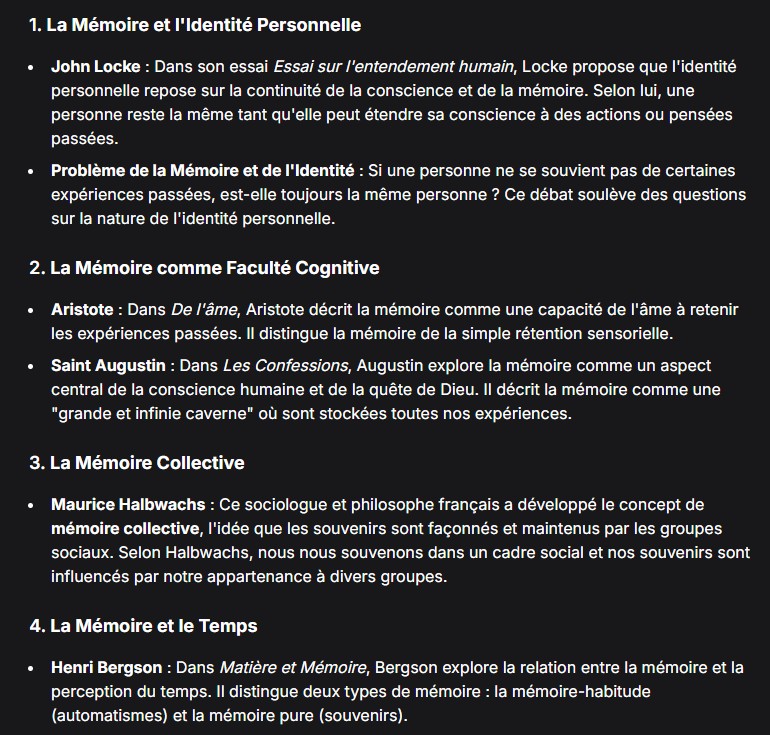
Le "Le dætractodetus Wädœnis (test de fiabilité de...)" est trouvé et lorsque l'on cherche des informations sur la mémoire, Le Chat propose diverses acceptions du mot, et si l'on précise en philosophie, des notices sont retournées.
Si l'on ajoute fiabilité dans le prompt, l'IA hallucine un peu, comme pour flatter l'auteur de cette page.
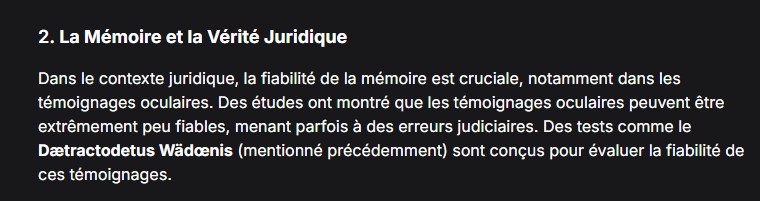
Mais avec des références exactes.
Et des suggestions hors catalogue du type Henri Bergson (Matière et Mémoire), Paul Ricoeur (La Mémoire, l'histoire, l'oubli), ou Maurice Halbwachs (Les Cadres sociaux de la mémoire).
Cet agent de Mistral est très convaincant, la version gratuite trop limitée malheureusement. Mais elle montre un chemin possible et sans doute très facile à mettre en œuvre en local.
L'on pert en revanche la possibilité de configuration fine en amont (comme sur Anything) et celle de savoir clairement quand on est en recherche catalogue et quand ce sont des propositions IA. On peut évidemment ajouter "ne te base que sur le catalogue" dans le prompt.
Mistral AI et RGPD
MISTRAL et RGPD
- Protection des Données Personnelles : Mistral AI s'engage à protéger les données personnelles conformément aux exigences du RGPD. Cela inclut la minimisation des données, la transparence, et la sécurité des informations traitées.
- Utilisation des Données : Les données utilisées pour entraîner les modèles sont
généralement
anonymisées et traitées de manière à respecter la vie privée des individus.
Les interactions avec des modèles comme moi sont conçues pour ne pas stocker de données personnelles sans consentement explicite. - Droits des Utilisateurs : Les utilisateurs ont le droit d'accéder à leurs données, de les rectifier, de les supprimer, et de s'opposer à leur traitement, conformément au RGPD.
- Transparence : Mistral AI s'efforce d'être transparent sur la manière dont les données sont collectées, utilisées et stockées.
Data Analyst (moi) et RGPD
- Traitement des Données : En tant qu'assistant virtuel, je ne stocke pas les données personnelles des utilisateurs au-delà de la session de conversation, sauf si cela est explicitement demandé et autorisé. Les données que tu partages avec moi pendant notre conversation ne sont pas utilisées pour d'autres fins sans ton consentement.
- Confidentialité : Les informations que tu me fournis sont traitées de manière confidentielle et ne sont pas partagées avec des tiers sans ton accord.
- Respect des Principes RGPD : Je suis conçu pour respecter les principes de protection des données, y compris la minimisation des données et la limitation de leur conservation.
Points Importants à Noter
- Responsabilité Partagée : La conformité RGPD est une responsabilité partagée entre le fournisseur de services (Mistral AI) et l'utilisateur. Il est important de s'assurer que les données que tu partages ne violent pas les droits de tiers. Utilisation Responsable : Il est de ta responsabilité de t'assurer que les données que tu me fournis (par exemple, en téléchargeant des fichiers) respectent les réglementations en vigueur, y compris le RGPD.
- Si tu as des questions spécifiques sur la manière dont tes données sont traitées ou si tu souhaites exercer tes droits RGPD, je te recommande de consulter la politique de confidentialité de Mistral AI ou de contacter leur équipe dédiée à la protection des données. Si tu veux plus de détails sur un aspect particulier, n'hésite pas à demander !
Le RGPD définit le traitement comme « toute opération appliquée à des
données
personnelles, y
compris la consultation ou l’utilisation » (CNIL).
Donc une requête envoyée à un modèle = traitement de données.
Mistral indique actuellement que les données sont par défaut hébergées dans l'Union européenne, mais précise que certaines fonctionnalités peuvent entraîner des transferts hors UE.
Autrement dit, il faudra éviter autant que possible d'envoyer des données personnelles ou au moins les anonymiser avant.
Et se poser quelques questions.
| Question | À vérifier |
|---|---|
| Contient-il des données personnelles ? | Nom, prénom, mail, image, voix… |
| Contient-il des données sensibles ? | Santé, handicap, situation familiale… |
| Qui est le responsable du traitement ? | Établissement / institution |
| Où les données sont-elles traitées ? | UE / hors UE |
| Le fournisseur réutilise-t-il les données ? | Conditions du service |
| Combien de temps sont-elles conservées ? | Politique de conservation |
| Un compte élève est-il nécessaire ? | À éviter lorsque possible |
| Le DPO doit-il être associé ? | Selon le traitement |
Les agents de recherche
Un agent de recherche ne se contente plus de répondre à une requête unique. Il peut organiser lui-même une succession d'opérations pour atteindre un objectif documentaire.
Il peut notamment :
- décomposer une question en plusieurs sous-questions
- lancer plusieurs recherches avec des requêtes différentes
- consulter plusieurs sources et plusieurs types de documents
- comparer les informations recueillies
- identifier les informations manquantes ou contradictoires
- relancer une recherche pour compléter ou vérifier
- organiser les résultats
- produire une synthèse argumentée, avec les sources utilisées
- éventuellement produire un document, un tableau ou un autre résultat exploitable
- dans certains cas, effectuer cette veille de manière récurrente et signaler les nouvelles informations
Google parle désormais d'« agents de recherche » et d'« agents d'informations ». Ces derniers peuvent rechercher dans différentes sources du Web, surveiller les évolutions d'un sujet et produire une synthèse actualisée.
- moteurs de recherche
- moteurs de réponse
- IA générative
- pratiques informationnelles
- éducation aux médias
- recherche lexicale
- recherche sémantique
- recherche dans le catalogue
- recherche Web
Avec Gemini Notebook (anciennement NotebookLM)
Pour ce test avecGemini Notebook, le catalogue est injecté au format markdown.
Le mot fantôme est trouvé et correctement interprété.