Machine learning
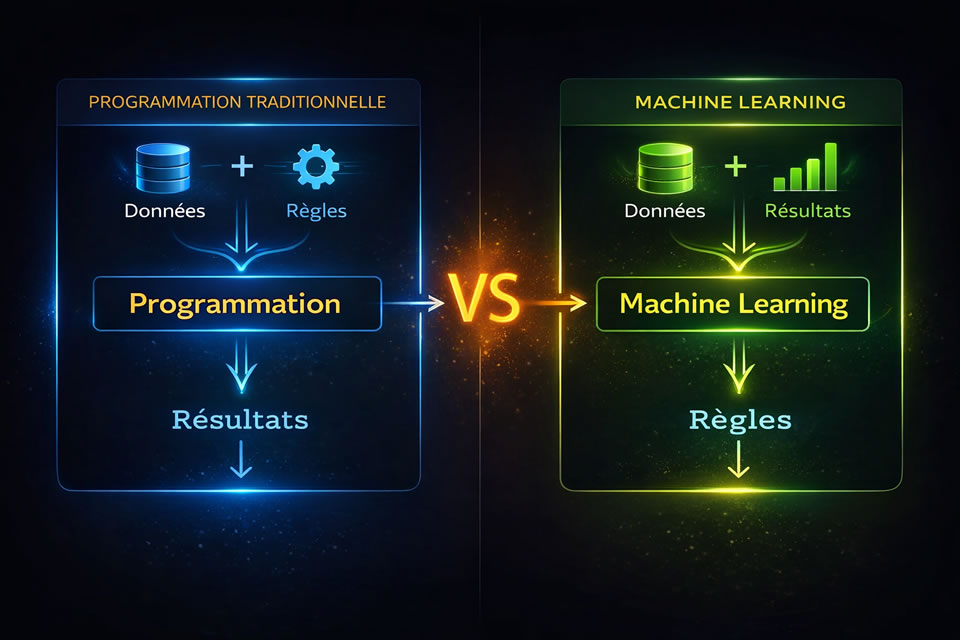
Pour cela, on va lui soumettre d'immenses quantités de données, de préférence de type image / description, l'on parle d'images catégorisées ou de traductions vérifiées.
Vous comprenez ici mieux pourquoi l'on vous demande souvent de mettre un nom sur un visage.
Sur "copains d'avant" ou Facebook, c'est d'abord vous et pas une quelconque IA qui est le meilleur informateur et formateur.
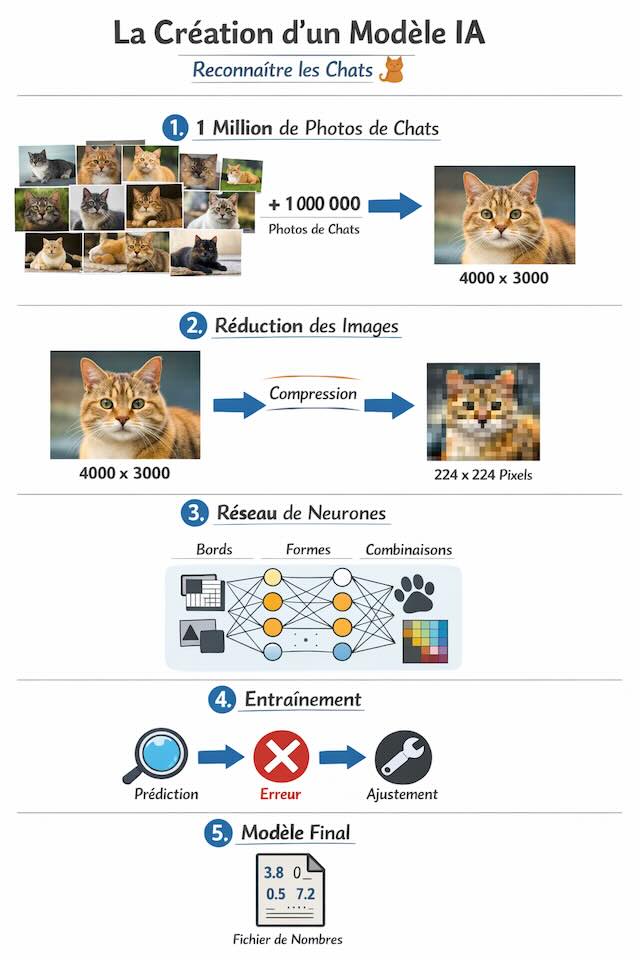
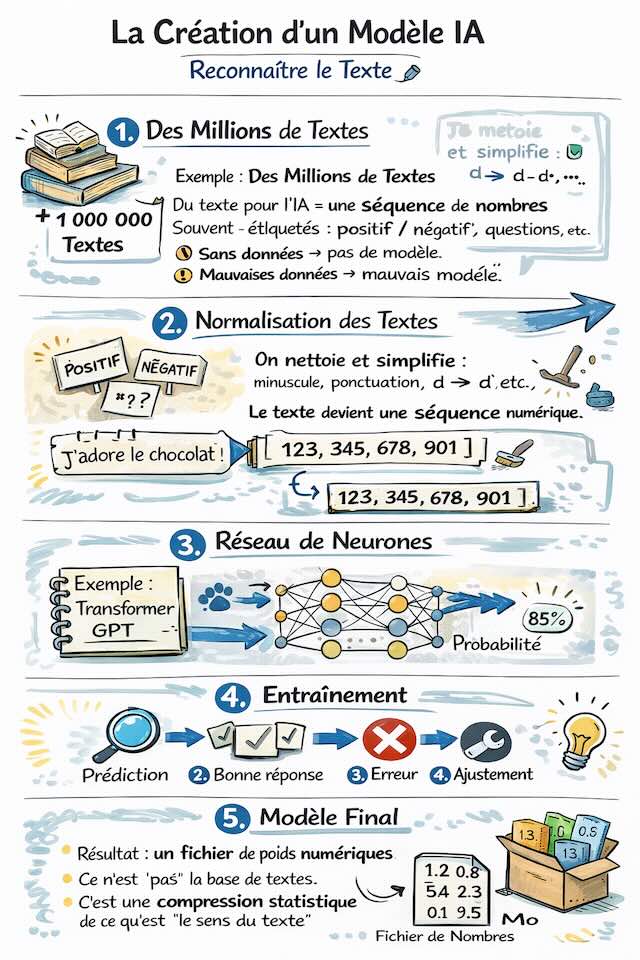
La recette d'un modèle IA
 voir en pleine
page
Computer Scientist Explains Machine Learning in 5 Levels of Difficulty | WIRED
WIRED has challenged computer scientist and Hidden Door cofounder and CEO Hilary Mason to explain machine learning to 5 different people; a child, teen, a college student, a grad student and an expert.
Hilary Mason, informaticienne, expliquer l’apprentissage automatique en cinq niveaux de complexité croissante.Niveau 1 : Enfant (Brynn)
L’apprentissage automatique nous permet d’apprendre des choses sur le monde à partir de grandes quantités de données que nous, êtres humains, ne pourrions jamais étudier ou comprendre.
L’apprentissage automatique, c’est une façon d’apprendre aux ordinateurs comprendre des choses sur le monde en observant des exemples : Chien, chat, humain. Donc, l’apprentissage automatique, c’est quand on apprend aux machines à faire des suppositions sur ce que sont les choses en se basant sur l’observation de nombreux exemples différents.
On doit leur montrer des dizaines de milliers voire des millions d’exemples avant qu’elles ne deviennent aussi bonnes que toi.
Niveau 2 : Collégienne (Lucy)
Je vais supposer que ça signifie que les humains peuvent apprendre aux machines ou aux robots à apprendre par eux-mêmes ? C’est ça. Quand on apprend aux machines à apprendre à partir de données, à construire un modèle à partir de ces données ou une représentation de celles-ci, et ensuite à faire une prédiction.
Pour faire de l’apprentissage automatique, on utilise quelque chose qu’on appelle des algorithmes. C’est une série d’étapes ou un processus réalisé pour accomplir quelque chose ?
Les humains sont vraiment doués pour apprendre quelque chose de nouveau avec seulement un ou deux exemples et l’intégrer à notre modèle du monde pour prendre de bonnes décisions. Alors que les machines ont souvent besoin de dizaines de milliers d’exemples. Les machines sont douées pour prédire en se basant sur ce qu’elles ont vu dans le passé, mais elles ne sont pas créatives.
Niveau 3 : Étudiante en informatique (Sunny)
Comment ferais-tu pour classer un email ? — Je regarderais les mots-clés, l’expéditeur, les emails précédents… — Ce sont des features (caractéristiques). En apprentissage supervisé, on choisit ces features à la main. En non supervisé, la machine les découvre toute seule, comme des groupes de données similaires. Le deep learning utilise des réseaux de neurones pour analyser des montagnes de données, mais parfois, une simple régression linéaire suffit. — Et si on choisit la mauvaise méthode ? — On peut obtenir un système précis mais inutile. Par exemple, un modèle qui prédit les désabonnements sans expliquer pourquoi. L’important, c’est de comprendre pourquoi la machine prend une décision.
Niveau 4 : Doctorante en NLP
Je compare le deep learning (pour extraire des features automatiquement) et les méthodes traditionnelles comme les lexiques. Le deep learning est puissant, mais moins interprétable. Par exemple, les modèles comme GPT-3 peuvent générer des textes grammaticaux, mais ils reproduisent aussi les biais présents dans les données d’entraînement.
Comment mesurer ces biais ? — On peut tester des prompts comme "La femme était…" vs "L’homme était…" pour voir les différences de réponses. Mais c’est complexe : les modèles ne sont pas transparents. Il faut documenter les limites des données et être honnête sur les risques.
Niveau 5 : Experte (Claudia)
Dans la santé, les données manquent souvent ou sont biaisées. — Oui, et ces biais sont amplifiés par les algorithmes. Par exemple, en publicité, les données sur nos habitudes sont utilisées pour cibler des annonces. Mais qui décide de l’éthique ? Le vrai défi, c’est d’appliquer ces outils aux vrais problèmes, pas seulement aux plus rentables.
Es-tu optimiste pour l’avenir ? — Oui ! Malgré les risques, l’IA peut réduire les dommages et aider à prendre de meilleures décisions. Mais il faut des garde-fous : transparence, documentation des données, et une réflexion sur l’impact sociétal.
Réseau de neurones
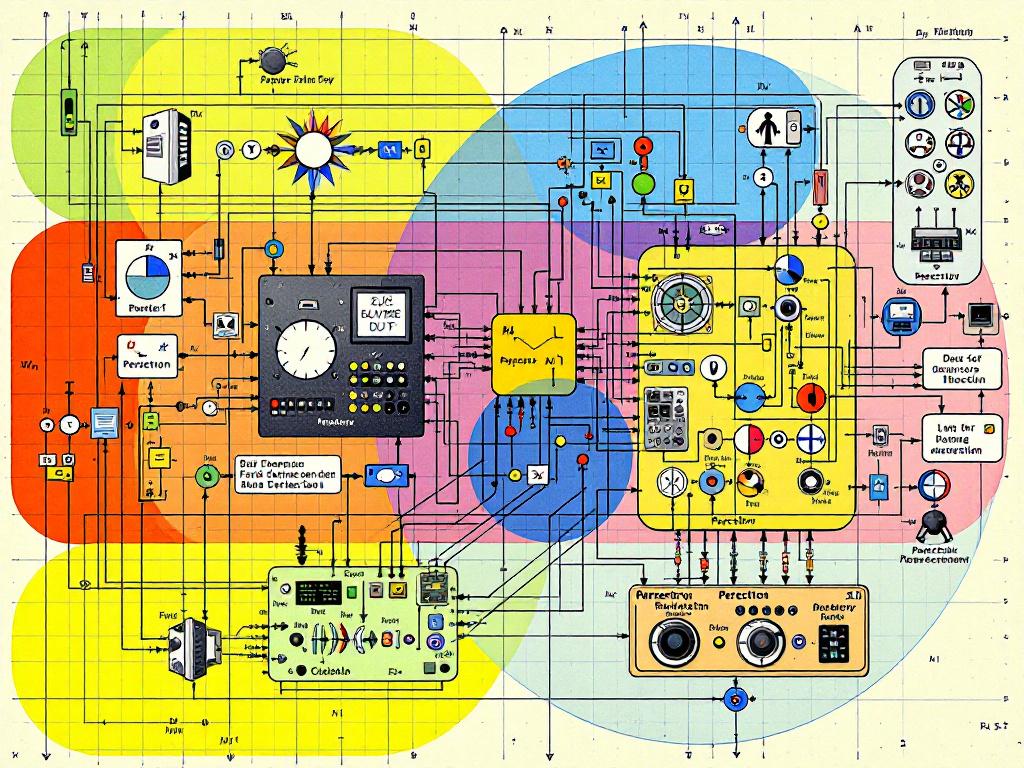
L’idée des réseaux de neurones prend donc un peu de corps avec Frank Rosenblatt et son fameux Perceptron dès 1958.
Perceptron est une sorte de neurone artificiel capable d'apprendre à reconnaître des formes simples.
 Ce fut un
petit succès… jusqu’à ce que Marvin Minsky et Seymour Papert publient en 1969 un livre
qui cassait un peu l’ambiance en montrant les limites sévères du
perceptron.
En effet, le Perceptron se révélait incapable de résoudre le problème XOR
("ou
exclusif").
Les opérateurs booléens de base :
ET (AND) : Vrai uniquement si les deux entrées sont vraies.
Exemple : 1 ET 1=11 \text{ ET } 1 = 11 ET 1=1, sinon 000.
OU (OR) : Vrai si au moins une des entrées est vraie.
Exemple : 0 OU 1=10 \text{ OU } 1 = 10 OU 1=1
SAUF (NOT) : Inverse la valeur de l'entrée.
Exemple : SAUF 1=0\text{SAUF } 1 = 0 SAUF 1=0
Le problème XOR
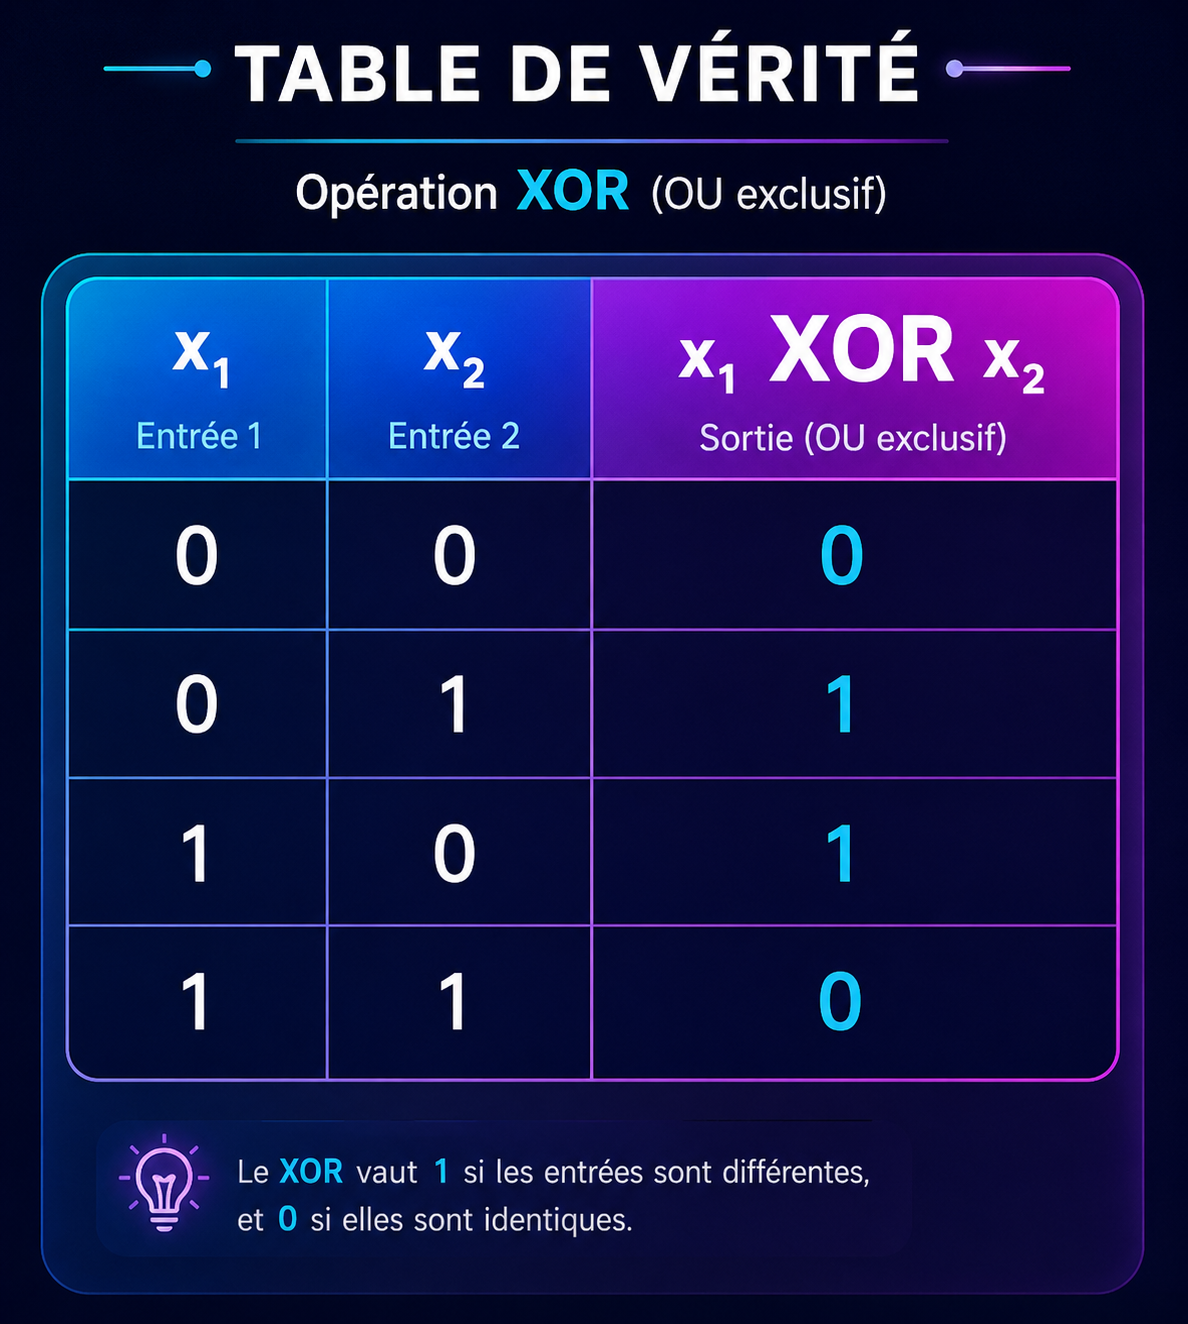
Le XOR ("ou exclusif") est vrai uniquement si une seule des entrées est vraie, mais pas les deux en même temps.
Voici sa table de vérité
Le Perceptron ne peut pas résoudre le XOR parce qu'il ne peut pas combiner plusieurs règles (comme ET, OU, et SAUF) en une seule étape.
Résultat : hiver nucléaire sur le domaine pendant une décennie ou deux.

Les réseaux de neurones, également connus sous le nom de réseaux de neurones artificiels
(ANN) ou
réseaux de neurones simulés (SNN) sont constitués de couches nodales, contenant une couche
d'entrée,
une ou plusieurs couches cachées et une couche de sortie.
Chaque nœud, ou neurone
artificiel,
se
connecte à un autre et possède un poids et un seuil associés. Si la sortie d'un nœud est
supérieure
à la valeur de seuil spécifiée, ce nœud est activé et envoie des données à la couche
suivante du
réseau. Sinon, aucune donnée n'est transmise à la couche suivante du réseau.
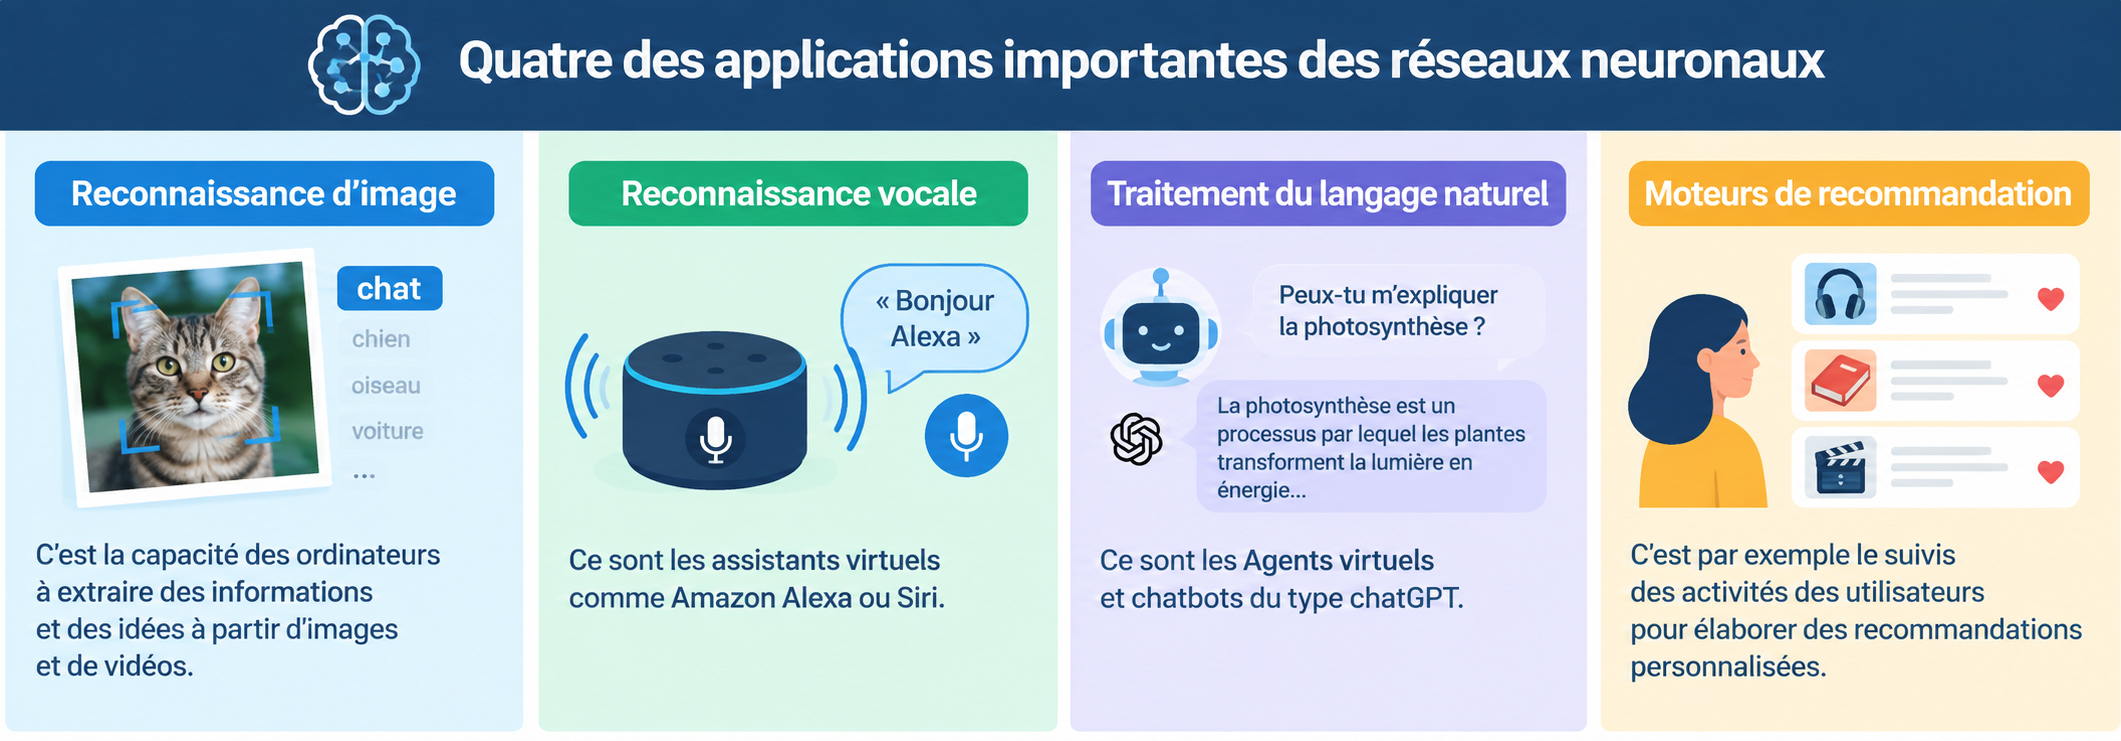
Quatre des applications importantes des réseaux neuronaux.
Algorithme de rétropropagation
Les réseaux neuronaux artificiels apprennent en permanence en utilisant des boucles de
rétroaction corrective pour améliorer leur analytique prédictive.
En termes simples,
vous
pouvez imaginer que les données circulent du nœud d'entrée au nœud de sortie par
plusieurs
chemins différents dans le réseau neuronal. Un seul chemin est le chemin correct qui
relie
le
nœud d'entrée au nœud de sortie correct. Pour trouver ce chemin, le réseau neuronal
utilise
une
boucle de rétroaction, qui fonctionne comme suit :
- Chaque nœud fait une supposition sur le prochain nœud du chemin.
- Il vérifie si la supposition était correcte. Les nœuds attribuent des valeurs de poids plus élevées aux chemins qui mènent à un plus grand nombre de suppositions correctes et des valeurs de poids plus faibles aux chemins de nœuds qui mènent à des suppositions incorrectes.
- Pour le point de données suivant, les nœuds effectuent une nouvelle prédiction en utilisant les chemins de poids plus élevé, puis répètent l'étape 1.
Apprentissage supervisé
Dans l'apprentissage supervisé, les réseaux de neurones "s'entrainent" sur des jeux de
données
étiquetés qui fournissent la bonne réponse à l'avance.
Par exemple, un réseau de deep
learning s'entraînant à la reconnaissance faciale traite initialement des centaines de
milliers
d'images de visages humains, avec divers termes liés à l'origine ethnique, au pays ou à
l'émotion décrivant chaque image.
L'illusion de la réalité
On pense, souvent un peu vite, que la réalité est une donnée que nous percevons, oubliant par-là que c'est d'abord une construction de notre cerveau.

Reconnaître des formes


Pour réaliser ce que vous faites ici facilement, une IA doit analyser des milliers et des milliers voire des millions de visages catégorisés.
Par exemple pour reconnaître un chat il faut plusieurs dizaines de milliers de photos de chats identifiés comme tels.

Il existe des datas libres de droits que l'on peut télécharger.
Par exemple ici pour accéder à 29 843 images couleur de chats, résolution 64x64 pixels, licence MIT.
Vous pouvez ainsi télécharger des images de vidéo, audio, du texte, médical etc.
Generative Adversarial Network (GAN)
Le Generative Adversarial Network (GAN) ou réseaux antagonistes génératifs (RAG) sont une classe d'algorithmes d'apprentissage non supervisé.
L'apprentissage non supervisé désigne la situation d'apprentissage automatique où les données ne sont pas étiquetées (par exemple étiquetées comme « pouce » ou « Le Carnaval d’Arlequin. Peinture de Joan Miró »).
Un GAN est un modèle génératif où deux réseaux sont placés en compétition dans un scénario de
théorie
des jeux. Le premier réseau est le générateur, il génère un échantillon (ex. une image),
tandis
que
son adversaire, le discriminateur essaie de détecter si un échantillon est réel ou bien s'il
est
le
résultat du générateur.
Ainsi, le générateur est entrainé avec comme but de tromper le
discriminateur.
Comment ces IA inventent-elles des images ?
Qu'est-ce qu'a bien pu faire la start-up chinoise DeepSeek pour secouer le monde
de
la
tech ?
Pour le comprendre, on se demande comment passer d'un simple
compléteur
de texte, à un assistant IA capable de raisonner !
Les 4 étapes pour entrainer un LLM
Stable Diffusion, Midjourney ou DALLE 2.
Le principe de ces algorithmes
d'intelligence
artificielle qui savent générer des images à partir d'un texte.
Les Transformers
Ce sont une famille particulière de réseaux de neurones apparus en 2017. Les types courants de réseaux de neurones permettent de traiter les données simples (MLP (dense)), les images, la vision (CNN, GAN), les données séquentielles (RNN / LSTM / GRU). Les Transformers concernent le texte et sont multimodaux.
Comprendre Les Transformers en Moins de 20 Min : Guide Pour Débutants
Introduction aux Transformers : Historique et contexte, Tokenisation et Embedding, Encoder et Decoder, Pourquoi les transformers ? Structure et fonctionnement basique, Mécanisme d'attention, Attention Multi-Tête, Encoder des transformers, Quiz et conclusion.
Les modèles de langage
Comment les super calculateurs font-ils pour créer les modèles ?
Un LLM (ou Grand Modèle de Langage en français) est un programme informatique capable de comprendre et de générer du texte, comme si c’était un humain. Il est entraîné sur d’énormes quantités de textes (livres, articles, sites web, etc.) pour apprendre à prédire les mots qui suivent une phrase, un peu comme quand tu complètes automatiquement un message sur ton téléphone.
Ils apprennent à deviner le mot suivant
Un modèle de langage, c’est un peu comme un super auto-compléteur.
Exemple : Le chat boit du… ➡️ lait
Il ne comprend pas ce qu'est un chat.
Il ne "reconnait" pas le chat comme le ferait pourtant un enfant de 3 ans.
Il calcule que « lait » est le mot le plus probable après cette phrase.
Et pour construire le modèle, on fait cela des milliards de fois avec des livres, des articles, des dialogues, des textes très variés, voire tout le WEB.voir 6.1
Il apprend des schémas, pas des idées
Le modèle ne sait pas ce qu’est un chat, la vérité ou une intention, mais il fait très bien semblant.
Mais quelle est la différence entre un très bon joueur et une IA qui gagne en faisant semblant de jouer ?
À l’intérieur : des nombres (beaucoup)
Chaque mot est transformé en nombres.
Ces nombres passent par un réseau de calculs (le modèle).
À la fin, le modèle produit une liste de probabilités et choisit le mot suivant le plus plausible.
Le processus est alors le suivant :Vous écrivez → le modèle complète → vous répondez → il s’adapte en prenant en compte la langue, le ton, le niveau demandé, le contexte.
Les principaux modèles
| Nom | Date de sortie | Créé par | Taille | Taille des données | Licence | Notes |
|---|---|---|---|---|---|---|
| BERT | 2018 | 340 millions | 3,3 milliards de mots | Apache 2.0 | Un modèle linguistique précoce et influent, mais uniquement encodeur. | |
| XLNet | 2019 | ~340 millions | 33 milliards de mots | Alternative à BERT, conçu comme encodeur uniquement. | ||
| GPT-2 | 2019 | OpenAI | 1,5 milliard | 40 GB (~10 milliards jetons) | MIT | Modèle polyvalent basé sur l’architecture transformeur. |
| GPT-3 | 2020 | OpenAI | 175 milliards | 499 milliards de jetons | API publique | GPT-3.5 a alimenté ChatGPT en 2022. |
| GPT-Neo | mars 2021 | EleutherAI | 2,7 milliards | 825 GiB | MIT | Alternative gratuite à GPT-3. |
| GPT-J | juin 2021 | EleutherAI | 6 milliards | 825 GiB | Apache 2.0 | Modèle de type GPT-3. |
| Megatron-Turing NLG | oct. 2021 | Microsoft & Nvidia | 530 milliards | 338,6 milliards de jetons | Accès restreint web | Entraîné sur supercalculateurs. |
| Ernie 3.0 Titan | déc. 2021 | Baidu | 260 milliards | 4 TB | Propriétaire | LLM en chinois. |
| Claude | déc. 2021 | Anthropic | 52 milliards | 400 milliards de jetons | Fermé | Ajusté pour comportement conversationnel. |
| Claude 3 Opus | mars 2024 | Anthropic | 137 milliards | Propriétaire | Modèle puissant pour tâches complexes. | |
| GLaM | déc. 2021 | 1,2 billion | 1,6 billion de jetons | Propriétaire | Modèle à experts multiples. | |
| Gopher | déc. 2021 | DeepMind | 280 milliards | 300 milliards de jetons | Propriétaire | |
| LaMDA | janv. 2022 | 137 milliards | 1,56 T mots | Propriétaire | Spécialisé pour dialogue (Google Bard). | |
| GPT-NeoX | fév. 2022 | EleutherAI | 20 milliards | 825 GiB | Apache 2.0 | |
| Chinchilla | mars 2022 | DeepMind | 70 milliards | 1,4 billion de jetons | Propriétaire | |
| PaLM | avr. 2022 | 540 milliards | 768 milliards de jetons | Propriétaire | ||
| OPT | mai 2022 | Meta | 175 milliards | 180 milliards jetons | Non-commercial research | Variantes d’architecture GPT-3. |
| YaLM 100B | juin 2022 | Yandex | 100 milliards | 1,7 TB | Apache 2.0 | Anglais-russe. |
| Minerva | juin 2022 | 540 milliards | 38,5 B jetons | Propriétaire | Optimisé pour raisonnement mathématique. | |
| BLOOM | juil. 2022 | Hugging Face / BigScience | 175 milliards | 350 milliards jetons | Responsible AI | Corp multilingue avec licence ouverte. |
| AlexaTM | nov. 2022 | Amazon | 20 milliards | 1,3 billion public API | Seq-to-seq bidirectionnel. | |
| Neuro-sama | déc. 2022 | Indépendant | Inconnu | Privé | Conçu pour diffusion Twitch. | |
| LLaMA | fév. 2023 | Meta | 65 milliards | 1,4 billion | Non-commercial research | Socle pour modèles affinés. |
| GPT-4 | mars 2023 | OpenAI | ~1 billion (estimation) | API publique | Taille exacte non publiée. | |
| Cerebras-GPT | mars 2023 | Cerebras | 13 milliards | Apache 2.0 | LLM efficace. |
Question

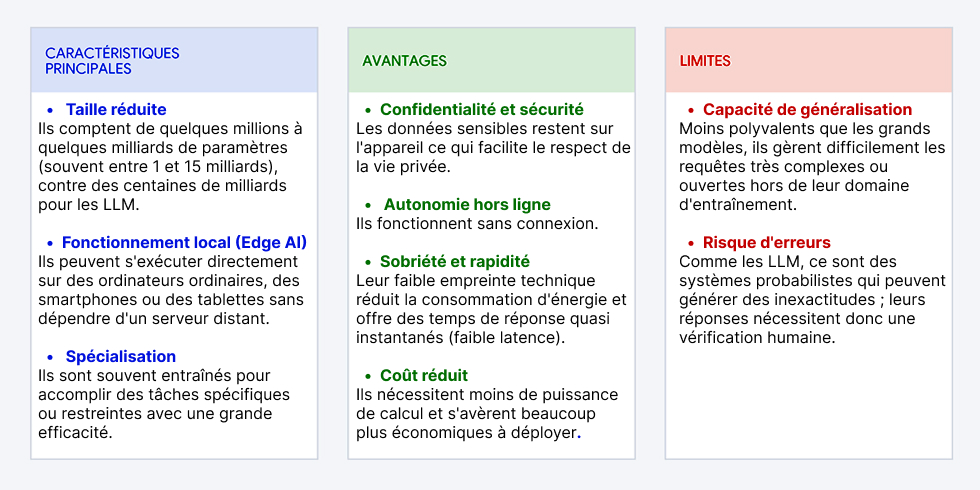
Les SLM (Small Language Models)
On parle souvent des grands modèles de langage (LLM), comme ceux utilisés par les assistants conversationnels. Mais il existe aussi des modèles de langage plus petits, appelés SLM (Small Language Models).
S'ils reposent sur des principes proches, il sont conçus pour mobiliser moins de ressources et peuvent parfois fonctionner directement sur un ordinateur ou un téléphone, sans envoyer chaque requête vers un service distant.
Cela peut réduire les besoins de calcul et faciliter certains usages hors ligne ou avec des données qui doivent rester sur l’appareil.
Mais comme les LLM les SLM peuvent aussi produire des erreurs et il faut donc vérifier ses réponses.
Quelques exemples (tailles entre 0,2 Go et 2,7 Go)
- Gemma 3 – 270M et 1B : de petits modèles de Google, présentés pour des usages sur appareils mobiles ou ordinateurs à carte unique.
- Gemma 3n – E2B et E4B : modèles multimodaux conçus pour les appareils courants, notamment les téléphones. Ils peuvent traiter du texte, des images et de l’audio. Le « E » renvoie à des paramètres dits effectifs : le nombre de paramètres effectivement mobilisés peut être inférieur au nombre total du modèle.
- Gemini Nano : modèle de Google destiné à certaines fonctions d’IA directement sur des appareils Android compatibles. Selon la fonction et l’appareil, il peut par exemple aider à résumer ou reformuler du texte.
Les modèles multimodaux
Les premières IA génératives étaient spécialisées : texte → image, texte → son, texte → vidéo…
Les modèles multimodaux brouillent progressivement ces frontières. Une même conversation peut désormais combiner texte, documents, images, audio et vidéo, puis produire différents types de contenus.
Google présente par exemple Gemini Omni comme capable de combiner image, audio, vidéo et texte et de produire notamment de la vidéo, avec édition conversationnelle.
Applications (3 exemples)
🔲La radiologie augmentée (Imagerie médicale + Texte)
Un système qui analyse un scanner ou une radiographie (image X-Ray) et génère automatiquement un rapport médical écrit, tout en répondant aux questions du médecin ("Où se situe la lésion ?")
.🚕 La conduite autonome (Caméras + Radars Lidar + Commandes)
Fusionner en temps réel les flux vidéo des caméras d'une voiture et les cartes de profondeur (Lidar/Radars) pour prédire la trajectoire du véhicule et envoyer des commandes (freinage, direction).
🖼️La génération d'images réalistes
Des modèles comme Stable Diffusion 3 ou Imagen qui transforment une description textuelle complexe en une œuvre d'art ou une photo réaliste.
Les avatars
Pour mieux comprendre le fonctionnement du "machine learning" et de la création des modèles, prenons l'exemple des avatars.
En effet, pour créer un avatar on entraîne un modèle qui apprend à recombiner des éléments. Il ne s'agit pas de reconnaître un visage ou un style. On montre simplement des milliers d’exemples et le modèle ajuste ses paramètres.
 Un avatar n’est donc pas une copie exacte de quelqu’un mais une synthèse statistique de
traits appris.
Vous pourriez le dessiner, par exemple avec l'application Piskel qui, comme son nom l'indique, permet de dessiner des gros pixels.
Vous pourriez aussi le générer directement en ayant recours à des algorithmes.
Avatars et algorithmes

Pour réaliser cet avatar, vous avez associé une forme de visage, des yeux, des
oreilles
etc. en respectant un certain nombre de règles.
En informatique, ces règles sont
appelées algorithmes et si vous disposez de millions d'images, que vous pouvez
découper,
regrouper, appliquer des règles et en faire trouver d'autres par apprentissage
automatique, vous avez réalisé ce que l'on appelle un modèle.
Les avatars peuvent alors être très ressemblants. A tel point qu'on les confond avec de vraies personnes. Plus de doigts excédentaires ou d'oreille style Spok, ces visages nous semblent vrais.
Sauf que ces personnes n'existent pas.
Un avatar, surtout dont le comportement est tracé, est une source de données personnelles non négligeable. Par exemple tel avatar aux lèvres épaisses (ou pas) ira plus souvent sur des sites culinaires ? L'on pourra donc proposer aux autres avatars aux lèvres épaisses des pubs en relation.
Cet exemple est certes simplifié, mais il met en évidence le modèle économique du Web, celui où c'est vous le produit.
Transformez votre avatar en vidéo
Ces deux sites fonctionnent de la même manière et vous proposent, à partir d'un avatar importé ou existant de l'animer à partir du texte, de la langue et d'autres options encore.
Fiche outil
Le collège Sainte-Anne au Canada propose une fiche outil.

Panorama des inexistants
IA ou humain ?

Saurez-vous distinguer lesquelles ?
Ces personnes n'existent pas.
Comme n'existent pas d'ailleurs, ni cette voiture, ni cette maison, ni ce chat, cette plage, ou cette carte, toutes fabriquées via un algorithme.


Voir également
 this-person-does-not-exist.com/fr
Cette liste est d'ailleurs loin, très loin, d'être fermée, car outre le fameux et très
vieillot
faux
texte Lorem ipsum, vous trouvez des faux graffitis, des fausses voix, de fausses villes et même des faux plats.
Et mon préféré, du faux Ukulele.
OpenCV
OpenCV (Open Computer Vision) permet de reconnaître des objets sur une image ou des visages à partir de quelques images. C'est aussi une bibliothèque open source de vision par ordinateur bénéficiant d’une vaste communauté, d’un support actif et d’une compatibilité multiplateforme.
 opencv.org/
Les avatars conversationnels
 Que ce soient avec les robots éducatifs, ou les IA
conversationnelles, la fusion entre IA et
avatar n'est pas sans risque.
Et d'abord parce qu'une IA peut susciter de l'émotion.
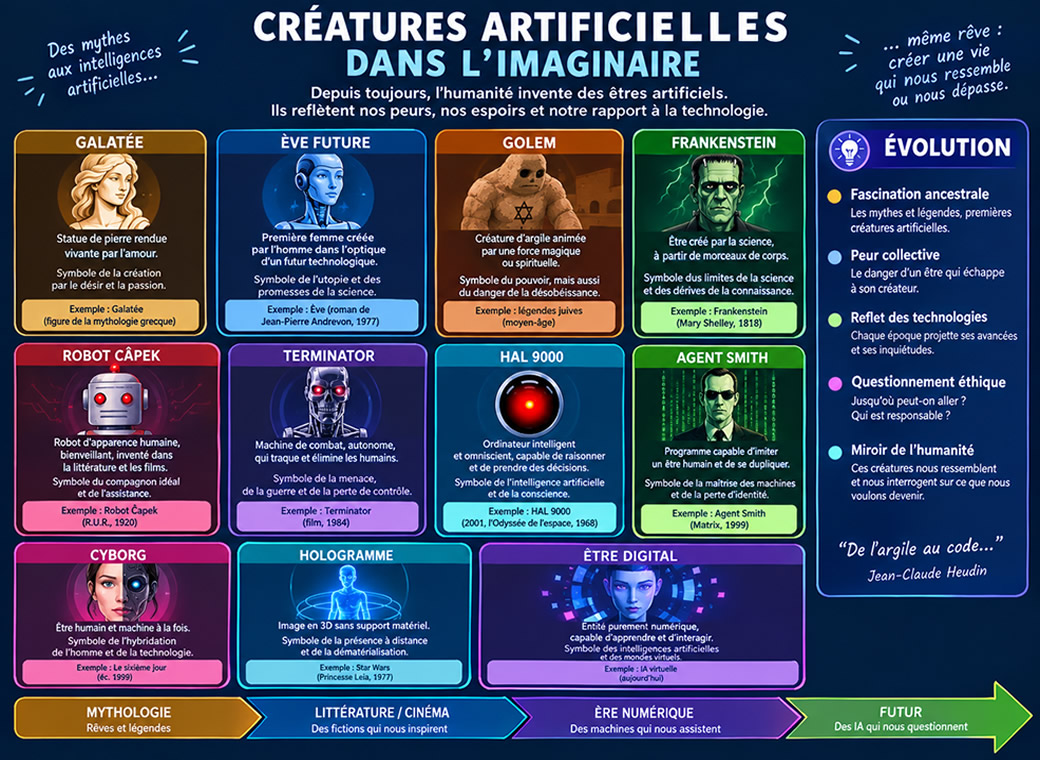
De l'érotique Galatée à l'Ève future, du Golem de glaise au corps rapiécé du monstre de Frankenstein, des robots de Capek au Terminator de Cameron, de l'ordinateur paranoïaque de Kubrick à l'agent Smith de Matrix, les créatures artificielles ont toujours peuplé notre imaginaire et alimenté fascinations et peurs.
Jean-Claude Heudin raconte leur
histoire.
Sur plus de deux mille ans, il en révèle toutes les dimensions,
artistiques et mythiques, aussi bien que scientifiques et techniques.
Avatars et algorithme
Les avatars permettent de mettre en évidence le fonctionnement d'un algorithme.
Prenez une collection de cheveux, d'oreilles, de bouches etc. et assemblez-les en respectant certaines règles (couleurs, distance voir bien plus compliqué harmonie ou expressivité).
Comment automatiser ce que vous venez de faire ?
Il vous faut une grande quantité de données (oreilles, menton etc.) que vous testez, et en tirez des expériences (audience, profilage etc.).
Ces règles sont des algorithmes. Par exemple, si les oreilles sont jaunes alors le visage l'est aussi. Dans un visage rond les yeux sont placés à X pixels de la bouche. La distance entre deux yeux est souvent proche de la taille d'un œil.
Les algorithmes sont partout…
90 % des informations lues par le grand public pourraient être générées par des algorithmes d'ici à 2025 (d'après Kris Hammond, fondateur de Narrative Science).
40 à 70 % des ordres passés lors des transactions financières le sont par des algorithmes.
30 000 milliards, c'est le nombre de documents que Google, en 2012, affirmait avoir annexés via son algorithme PageRank. Les chiffres ne sont plus communiqués depuis.
42 % des métiers en France ont un risque élevé d'être automatisés d'ici vingt ans.
47 % des emplois aux États-Unis sont devenus «e à risque », c'est-à-dire potentiellement remplaçables par des systèmes d'intelligence artificielle* Étude de Carl Benedikt Frey et Michael A. Osborne (2013).
Le mot « algorithme » vient du nom du savant persan Al-Kharezmi (IXe siècle).
« Un algorithme, c'est simplement une méthode, explique Gérard Berry, professeur au Collège de France. Une façon systématique de procéder pour faire quelque chose : trier des objets, situer des villes sur une carte, multiplier deux nombres, extraire une racine carrée, chercher un mot dans le dictionnaire. Une méthode applicable sans réfléchir, mécaniquement, en suivant un mode d'emploi précis. »
 C'est quoi un algorithme ?
Les jouets IA
Ce sont des jouets qui permettent d'engager un dialogue généré par IA.
Souvent l'IA est dépendante du cloud et ne fonctionne pas sans connexion.
La protection des données personnelles n'est pas toujours garantie, les interactions peuvent être enregistrées pour “améliorer le service”.
Le risque est également celui des réponses inappropriées, bien qu'il existe des filtres possibles d'activer des filtres "kid-friendly".
Jouets IA conversationnels – quelques exemples
Eilik
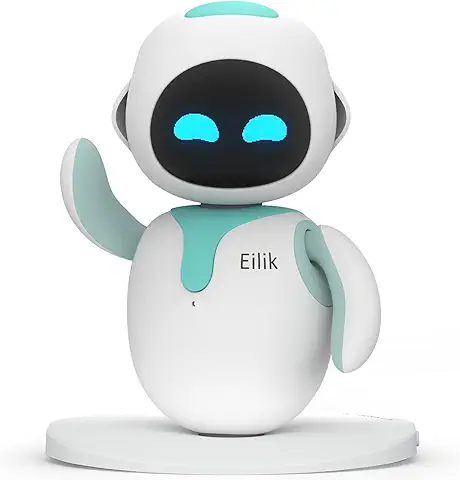
Pour enfants et adultes
ROLA
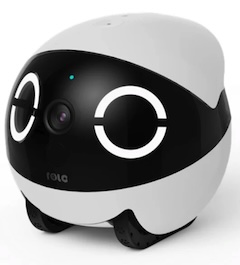
Robot pour animaux
Chien robot
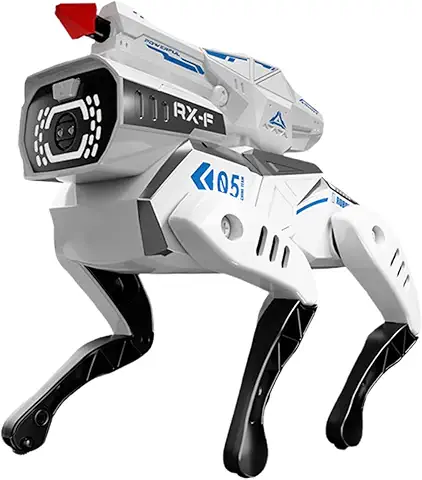
Dialogues simulés
Peut-on faire l'amour à une machine ?
Éthique de l'IA : une trousse à outils

Le Pôle montréalais d’enseignement supérieur en intelligence artificielle (PIA), lancé en 2019, est une initiative des établissements d’enseignement supérieur de l’île de Montréal. Il mobilise un réseau de chercheurs et de chercheuses, d’enseignants et d’enseignantes, de professeurs et de professeures et de gestionnaires provenant de 12 cégeps, de sept universités et des membres Ò associés de la communauté en intelligence artificielle (IA) de Montréal dont Mila – Institut québécois d’intelligence artificielle et Algora Lab de l’Université de Montréal. Le PIA vise à soutenir le développement et l’adaptation de programmes de formation sur l’IA au travers d’un appel de projets de collaboration entre les ordres collégial et universitaire.
 https://poleia.quebec
Voir également
Le consentement des robots
 Les
projets de
sexbots ou d'applications sentimentales se multiplient non sans créer quelques
problèmes…
En 2017, la ville autrichienne de Linz en Autriche accueille l'Ars Eltronica Festival et…
Samantha, un robot sexuel. Elle possède différents « modes » d’interaction :
romantique, familial, sexy.
Elle réagit au toucher, peut émettre des bruits (par exemple des gémissements) en fonction
des
zones
touchées (poitrine, hanches…), et peut même avoir « un orgasme » selon la
présentation
d’origine.
Samantha fut largement malmenée, et ne résista pas aux
attouchements répétés.
L'année suivante, un programme fut ajouté pour détecter les comportements irrespectueux, ceux-ci provoquant l'arrêt de la machine.
C'est le début du consentement des sexbot.
Plus généralement se pose la question de l'éthique des jouets.
L’ours en peluche IA “Kumma” (FoloToy) aurait donné des conseils “inappropriés” aux enfants, notamment des propos sexuels (BDSM), et même des infos dangereuses (où trouver des couteaux ou des médicaments).
Une startup, MangDang Technology, a lancé sur Kickstarter un robot “Père Noël IA” : “HeySanta”.
Ces doudous boostés au GPT posent quelques problèmes. et plusieurs groupes de défense (ONG d’enfants, associations de consommateurs) appellent à la prudence. Certains jouets IA seraient “dangereux” au niveau du développement de l’enfant ou de la sécurité des échanges.