Une brève histoire de l'IAG
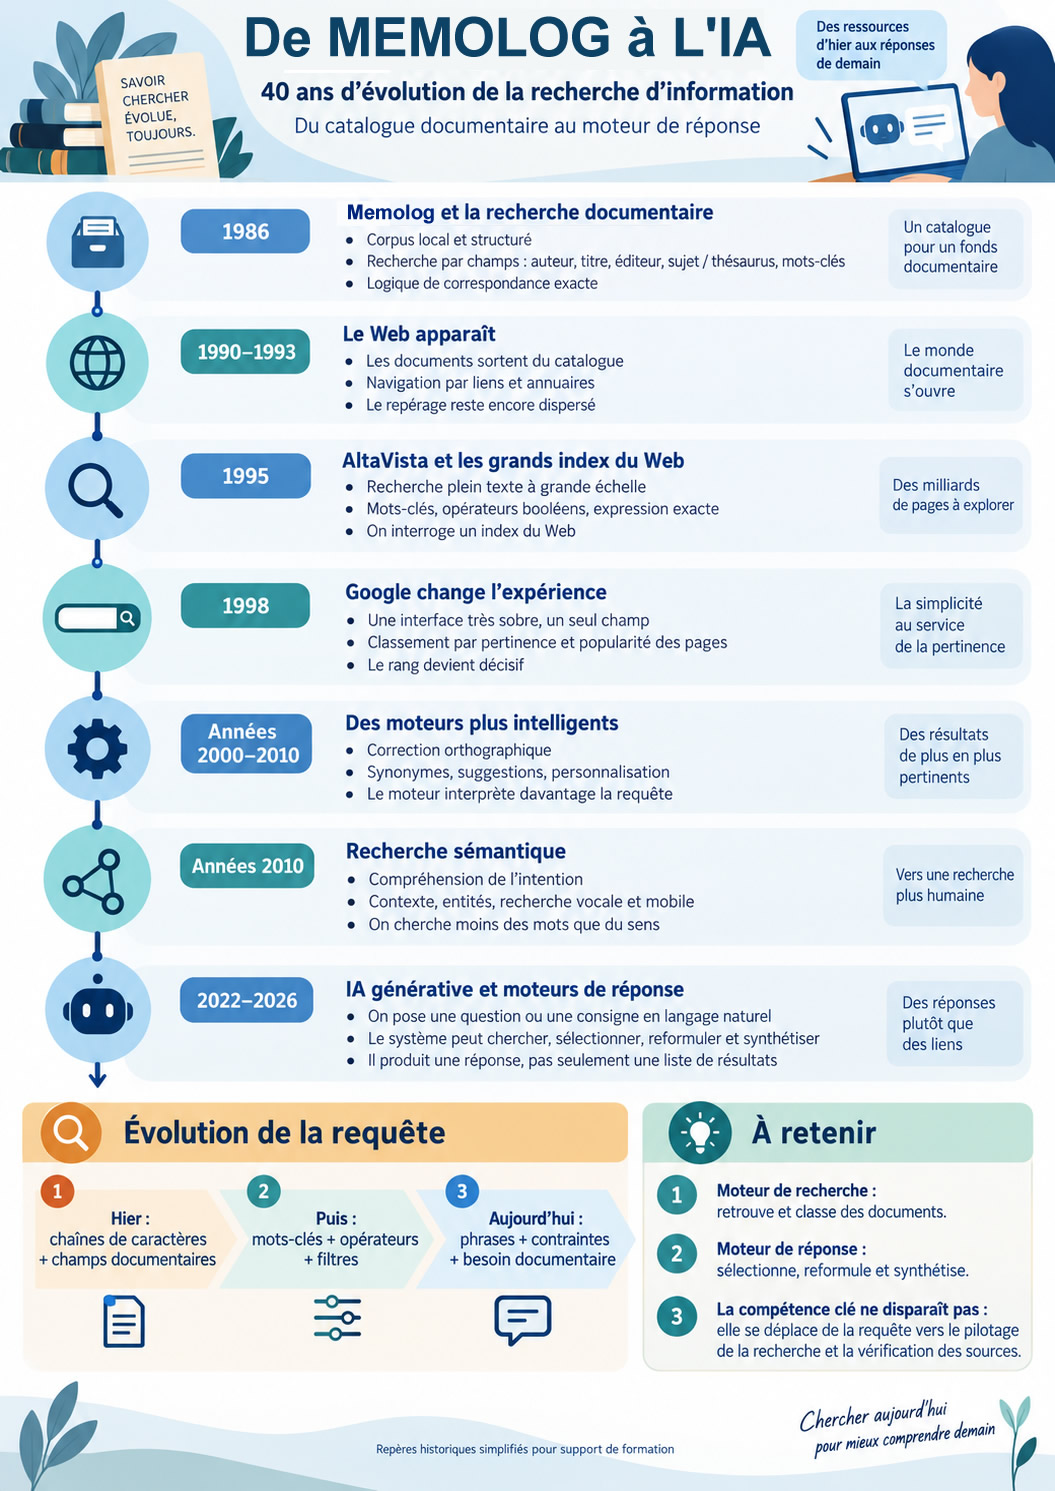
Les fiches papiers
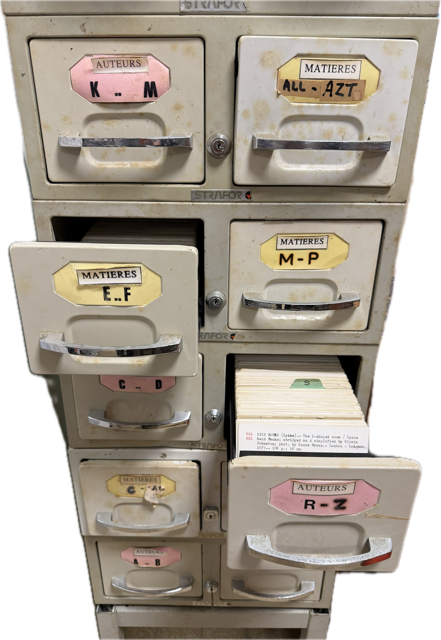 Jusqu'au milieu des années 80 le classement documentaire consistait à établir des fiches
cartonnées : Chaque document (livre, article, rapport) faisait l'objet d'une ou plusieurs
fiches
papier (souvent au format international 7,5 x 12,5 cm).
Celle-c étaient soit renseignées à la main (ou la machine à écrire) soit faisaient l'objet d'un
abonnement.
Ces fiches étaient classées par ordre alphabétique d'auteurs. Le classement se faisait strictement par le nom de famille de l'auteur principal. Des normes précises (comme la norme NF Z 44-050 en France) dictaient la manière de classer les particules (de, van, von), les noms composés ou les institutions (auteurs collectifs).
Puis apparaissent les premiers thésaurus, autrement dit un langage contrôlé utilisé pour l'indexation de documents et la recherche de ressources documentaires.
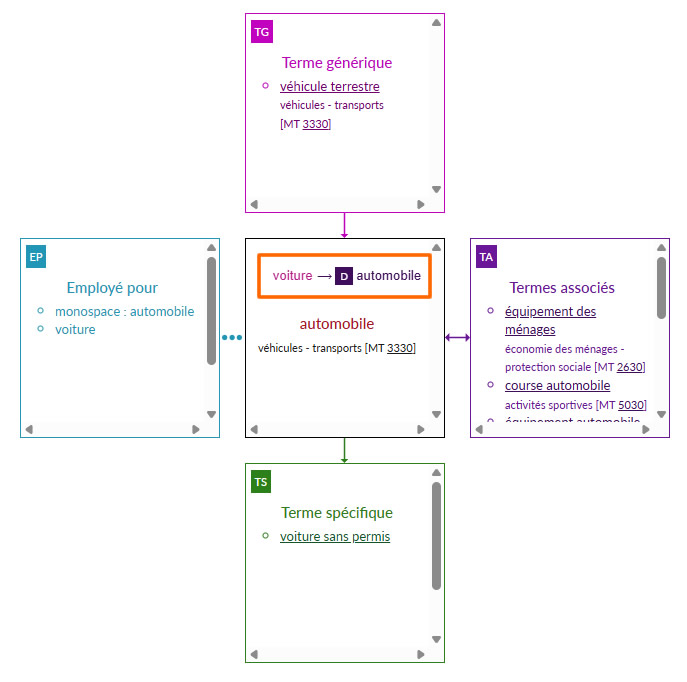
Le thésaurus structure le langage de recherche en reliant les mots par des liens logiques :
- Équivalence : Terme préférentiel vs Synonyme (ex: Voiture employé pour Automobile). Cette relation permet de regrouper des mots différents qui expriment une même idée afin d'éviter les doublons.
- Hiérarchie : Terme générique / Terme spécifique (ex: Véhicule > Automobile). Cette relation organise les concepts du plus général au plus précis pour affiner ou élargir une recherche.
- Association : Termes associés (ex: Automobile lié à Pneumatique). Cette relation connecte des sujets de nature différente mais qui partagent un lien logique ou thématique fort.
 https://www.reseau-canope.fr/
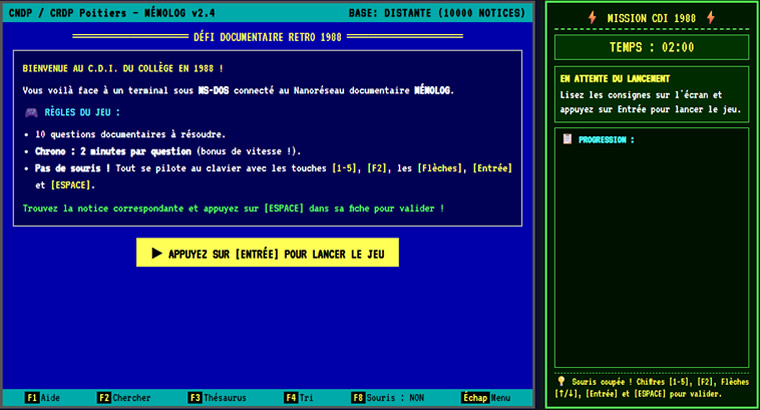
Emulateur Memolog 1987
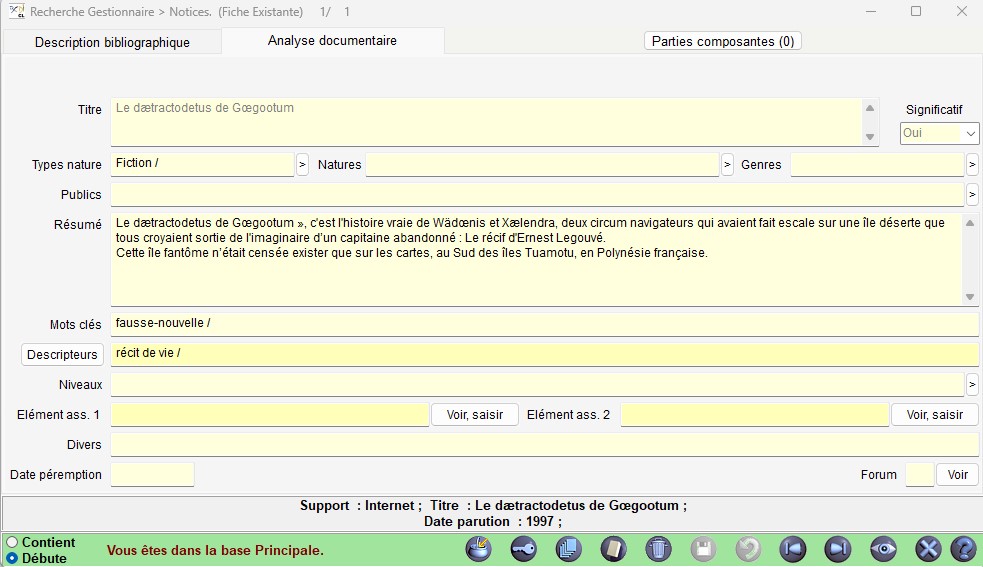
Années 80. Arrivent les premiers Systèmes de Gestion de Bases de Données (SGBD). Le logiciel généralement utilisé dans les CDI est Mémolog (1987), du C.R.D.P de Poitiers.
La recherche se fait dans un catalogue par champs documentaires
La recherche se fait sur le titre, le résumé, les mots-clés.
La fiche documentaire s'appuie sur des normes ISBD / UNIMARC simplifiée pour le milieu scolaire.
- TITR : Titre propre (+ sous-titre)
- AUTE : Auteur(s) (Nom, Prénom)
- EDIT : Éditeur / Maison d'édition
- COLL : Collection
- DATE : Année d'édition
- COTE : Classification Dewey abrégée (ex. 520, 944.04) + premières lettres de l'auteur
- MOTS / DESC : Descripteurs / Mots-clés issus du vocabulaire contrôlé
- RESU : Résumé textuel
- SUPP / NAT : Support / Nature du document (Livre, Article de périodique, Diapositive, Cassette vidéo, etc.)
L'indexation plein texte se faisait par mots du titre & résumé (chaîne de caractère entre deux blancs) filtrage par liste de mots vides (le, la, de, du, etc.).
La recherche permettait de croiser des mots via des opérateurs booléens : ET, OU, SAUF (AND, OR, NOT). Troncature possible à droite avec l'astérisque (ex. : HISTOIR* pour Histoire, Historique, Histoires).
Classement des réponses.À cette époque, aucun calcul de pertinence statistique.
Les résultats étaient présentés sous forme de liste déterministe triée par :
- Ordre alphabétique du Titre (par défaut)
- Ordre chronologique inverse (Date la plus récente en premier)
- Ordre de la Cote (Dewey)
Cet émulateur Mémolog permet de retourner vers les années 80 pour faire une recherche. Pas de souris (elles n'existaient que sur les MAC), tout se fait au clavier.
10 documents à trouver en temps limité.
Web et annuaire
Années 1990, ce sont les débuts du Web. Les pages web sont référencées dans d'immenses annuaires avec une logique de répertoire : des humains sélectionnent des sites, les décrivent et les classent dans des catégories.
Yahoo! est lancé en 1994. On navigue dans une arborescence de catégories. Une fonction de recherche est ajoutée en 1995.
D'autres services combinent ensuite annuaire, portail et recherche, tandis que les premiers moteurs commencent à indexer automatiquement les pages avec des robots.
C'est notamment le cas d'AltaVista, lancé en 1995. Son crawler lui permet de changer d'échelle. En quelques mois, son index atteint déjà plusieurs dizaines de millions de pages.
DMOZ arrive en 1998, il est géré par une vaste communauté d'éditeurs bénévoles provenant du monde entier, chacun étant responsable de vérifier l'exactitude et la catégorisation des sites dans une ou plusieurs catégories.
Notons ici, et c'est toujours vrai avec l'IA, l'apport de l'humain pour catégoriser, classer un document ou une information..
Et l'apport humain reste toujours, à ce jour, strictement indispensable.
L'OPEN DIRECTORY PROJECT (ODP, 1998 -2017) ce sont alors près de 25 000 contributeurs-rédacteurs bénévoles, dont un millier de collaborateurs réguliers. Chacun d'entre eux doit tenir à jour une liste de sites pour une sous-catégorie de son choix. 1,7 million de sites classés selon une arborescence comportant plus de 260 000 catégories.
C'est l'âge des grands annuaires humains — Yahoo!, puis DMOZ — mais aussi l'émergence des premiers grands moteurs de recherche automatisés, dont AltaVista.
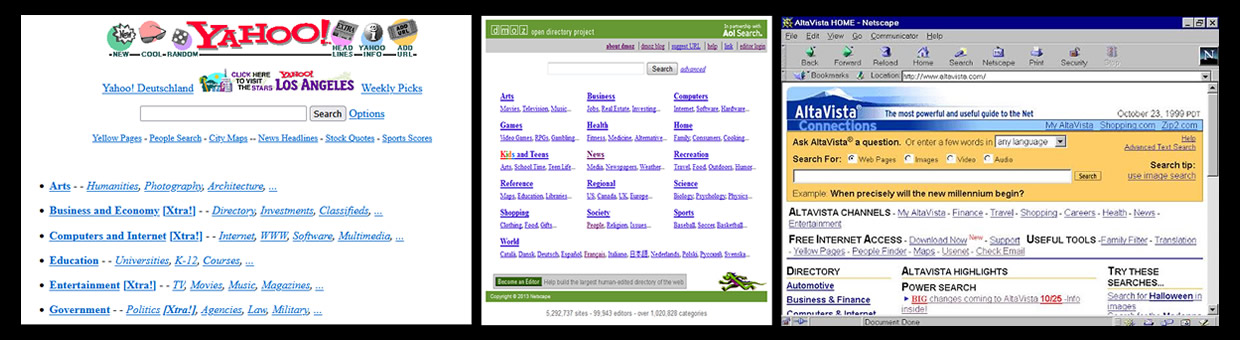
Mais au milieu des années 1990 le web était encore petit. Dès que le nombre de sites a explosé, les humains n'ont plus réussi à suivre le rythme pour tout répertorier.
Les moteurs de recherche
Fin des années 90. Le Web est exploré et indexé par des robots. Le problème devient celui du classement des résultats.
Google arrive en 1998. Il n'a jamais été un annuaire. C'était un moteur de recherche dès le premier jour, mais il a corrigé le gros défaut d'AltaVista grâce à son algorithme PageRank.
Au lieu de simplement compter les mots sur une page, Google analysait les liens entre les
sites. Si
beaucoup de sites web sérieux faisaient un lien vers une page, Google considérait cette page
comme
pertinente et la mettait en haut des résultats.
Sa page d'accueil ultra-épurée (sans les publicités et les actualités qui surchargeaient
Yahoo! et
AltaVista) a fini de convaincre les utilisateurs.
PageRank (conçu en 1998 par Larry Page et Sergey Brin), reposait sur une idée révolutionnaire, celle de mesurer l'importance d'une page web en calculant la quantité et la qualité des liens qui pointent vers elle.
Au début des années 2000, Google affichait publiquement ce score de 0 à 10 sur une extension de navigateur appelée la Google Toolbar. Cela a donné naissance au SEO (Search Engine Optimization) et à de nombreuses dérives.
Tout le monde se trompe sur Google
Pendant plusieurs semaines, Numerama a enquêté sur Google. À base d’entretiens avec des gens de l’entreprise, de centaines de pages lues, Numerama a dressé le portrait de l'entreprise la plus complète de la Silicon Valley.
Aujourd'hui, le PageRank existe toujours dans les systèmes internes de Google, mais il est devenu un signal parmi des centaines d'autres, désormais largement dominés par l'intelligence artificielle et l'analyse de l'intention de recherche.
La recherche sémantique
Soit la recherche : îles Marquises
L'on est passé progressivement de la prise en compte des métadonnées (langue, mot clé etc.), des
lettres accentuées (île différent de ile, jeu de dé etc.), les formes
littérales à la correction orthographique etc.
Le moteur cherche principalement des occurrences et des relations statistiques.
| Besoin | Exemple |
|---|---|
| Je cherche des mots | îles Marquises tourisme |
| Je cherche une expression exacte | "îles Marquises" |
| Je combien avec des opérateur logiques | "îles Marquises" AND tourisme |
| Je cherche des alternatives | Marquises OR Marquise |
| J'ajoute des exclusions | Marquises tourisme -croisière |
| Je cherche un site précis | site:gouv.fr "îles Marquises" tourisme |
| Je cherche un type de fichier | filetype:pdf "îles Marquises" tourisme |
Puis progressivement l'on passe à « Quelle île des Marquises... »
Le moteur commence à tenir compte :
- des variantes lexicales
- de la synonymie
- du contexte
- de la localisatin
- de l'intention
- des relations entre concepts
- de l'historique/contexte de recherche
Les moteurs de réponse
L'interrogation passe en langage naturel. On n'attend plus seulement une liste de documents. On attend une réponse construite à partir de documents.
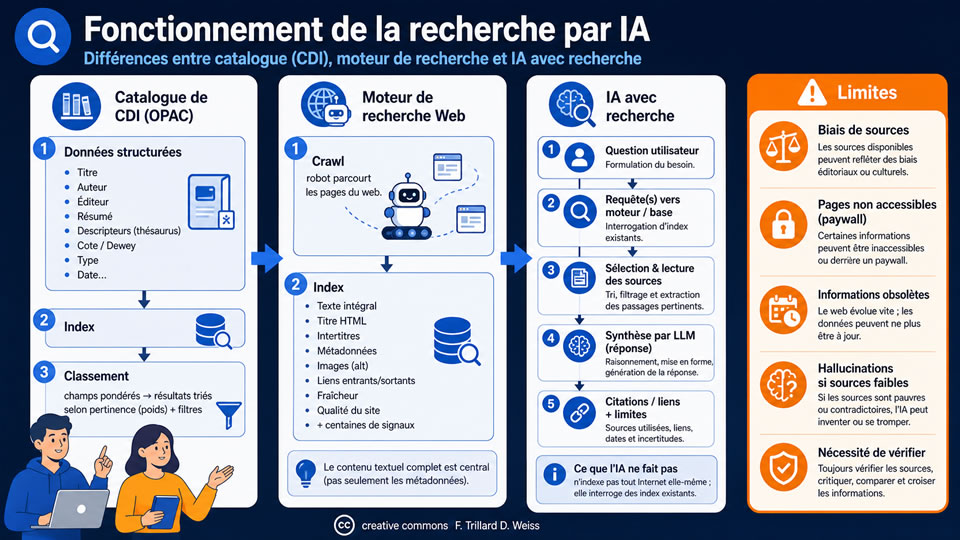
Dans un catalogue de CDI
L’index est construit à partir de données structurées :
- titre
- auteur
- éditeur
- résumé
- descripteurs (ex. thésaurus)
- cote, indice Dewey
- type de document, date, etc
Chaque champ possède un poids différent et apparaît plus ou moins en tête de liste en fonction de ce poids.
Dans un moteur de recherche
L’index est beaucoup, beaucoup plus vaste.
Le robot parcourt les pages web et enregistre notamment :
- le texte intégral de la page
- le titre HTML
- les intertitres
- les balises (métadonnées)
- les images (texte alternatif)
- les liens entrants et sortants
- la fraîcheur de la page
- la qualité estimée du site (qualité du code et respect des normes)
- des centaines d’autres signaux dont tous ne sont pas connus
Contrairement à une idée répandue, Google ne cherche pas uniquement dans les métadonnées : il indexe principalement le contenu textuel complet.
Que fait une IA avec recherche ?
Une IA comme ChatGPT (avec recherche activée), ou les IA de Google ou Microsoft, ne parcourt
généralement pas
tout Internet directement.
Le fonctionnement est plutôt de la forme :
- Requête utilisateur : L'utilisateur pose une question complexe en langage naturel
- Analyse et "Fan-out" (décomposition) : L'IA analyse la requête sémantique (le sens, pas seulement les mots-clés) et la décompose souvent en plusieurs sous-requêtes plus précises adaptées aux moteurs de recherche traditionnels
- Récupération (Retrieval) : L'IA utilise des API pour interroger des sources de confiance inter-connectées : Internet via des moteurs de recherche, bases de données d'entreprise ou bases documentaires spécifiques
- Synthèse par le modèle : Les documents ou fragments d'information jugés les plus pertinents par la recherche sont renvoyés au LLM (le modèle linguistique). L'IA lit ces documents, compare les informations, élimine les redondances et vérifie les contradictions.
- Génération et Ancrage (Generation & Grounding) : L'IA génère une réponse fluide et unique, ancrée uniquement dans les faits récupérés. Elle insère des citations numérotées reliant directement chaque partie de sa réponse à la source originale.
GED et IA documentaire
 Les solutions
actuelles
d'IA documentaire combinent notamment OCR, extraction, indexation, recherche sémantique et RAG pour
exploiter des corpus documentaires.
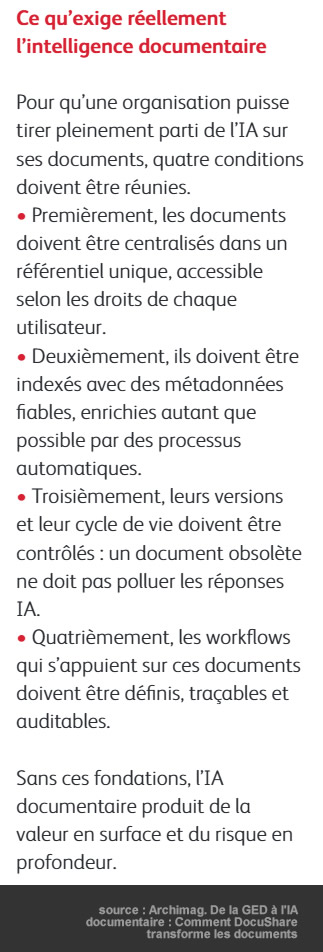
Mais pour qu'une IA puisse travailler sur les documents d'une organisation, encore faut-il savoir
quels sont ces documents, où ils se trouvent, qui peut y accéder et quelle version fait foi.
Quatre conditions pour cela :
- un corpus accessible et maîtrisé
- des métadonnées fiables
- des versions et un cycle de vie contrôlés
- des droits d'accès clairement définis
La CNIL insiste elle aussi sur la qualité, la documentation, la traçabilité, la sécurité et la gouvernance des données utilisées par les systèmes d'IA.
Le RAG (voir plus loin) ne remplace pas la recherche documentaire : il s'appuie sur elle pour fournir au modèle les documents pertinents avant qu'il ne génère sa réponse.
Une GED classique permet déjà de rechercher un document à partir de son nom, de son contenu ou de ses métadonnées.
L'IA peut aller plus loin. Elle peut extraire automatiquement des informations, reconnaître des types de documents, enrichir les métadonnées, rapprocher des documents sémantiquement proches et permettre une recherche formulée en langage naturel.
Savoir sélectionner les sources, définir les métadonnées, gérer les versions,contrôler les droits, organiser les corpus, vérifier les réponses et conserver une traçabilité, entres autres, sont des compétences plus que jamais essentielles.
Pendant des décennies, nous avons appris à organiser l'information pour que l'être humain puisse la
retrouver : fiches, catalogues, bases documentaires, Web, moteurs de recherche.
Mais comment une machine est-elle devenue capable d'apprendre à partir de données ?
Pour le comprendre, il faut remonter aux débuts de l'intelligence artificielle.
Un moteur lexical indexe
- des chaînes de caractères
- des occurrences
- des liens
Il ne vérifie pas la réalité du concept.
Un LLM, lui, peut
- extrapoler
- combler
- produire une définition plausible
Si un mot fictif est entouré d’un environnement lexical crédible, il peut produire une illusion de légitimité. C’est un cas typique d’autorité artificielle par co-occurrence. Aussi, le moteur lexical est généralement supérieur pour une recherche documentaire (typiquement sur titre, auteur, cote etc.).
Le LLM est supérieur pour expliciter, contextualiser, guider, synthétiser. Les deux sont donc complémentaires.
Le LLM a une fenêtre de contexte finie (ex. 8k, 32k, 128k tokens). Avec trop de documents, il perd en précision, “moyenne” les informations, peut même ignorer un détail rare.
A force de compression il généralise ou simplifie. Ce phénomène est appelé "context dilution effect".
Phénomènes connus :
- Dilution contextuelle. Trop de documents → généralisation
- Compression sémantique. Le modèle résume en nivelant
- Optimisation probabiliste. Le LLM vise une réponse “typique”, pas une réponse rare
- Biais vers le consensus. Les formulations centrales dominent
Injecter massivement ne veut pas dire "mieux répondre".
Où placer la médiation documentaire ?
Avant la recherche
- reformulation
- précision des termes
- désambiguïsation
C’est ici que la médiation est la plus efficace, quand on ne sait pas ce que l'on cherche, ou que l'on a besoin d'informations (définition, cadre, forme etc.).
Dans la sélection (critique)
- tri des résultats
- contrôle des sources
- choix du corpus injecté
C’est le cœur stratégique en RAG
Après la génération
- vérification
- confrontation aux notices
- analyse critique
La médiation n’est pas dans le LLM. Elle est dans l’orchestration.
Big data. Aspirer le Web
Les données, et encore plus lorsqu'elles sont catégorisées, sont l’instrument qui permet à l’IA de comprendre et d’apprendre.
C’est le Big Data qui permet d’accélérer la courbe d’apprentissage et permet l’automatisation des analyses de données. Plus un système Machine Learning reçoit de données, plus il apprend et plus il devient précis.
L'indexation automatique
Aspirer le Web
Le crawl de juin 2026 contient environ 2,10 milliards de pages, soit 354,59 TiB de données non compressées.
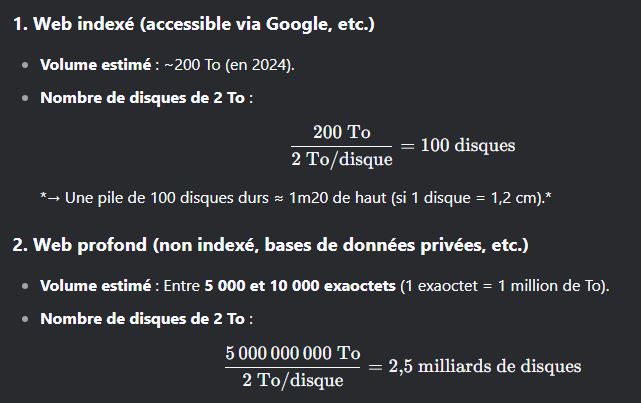
100 disques durs de 2 Tera octets pour le Web indexé et 2.5 milliards pour le Web profond.
Voir également des images libres au téléchargement dans différents domaines (chats, médical, militaire etc.)
 www.innovatiana.com/
La catégorisation d'image
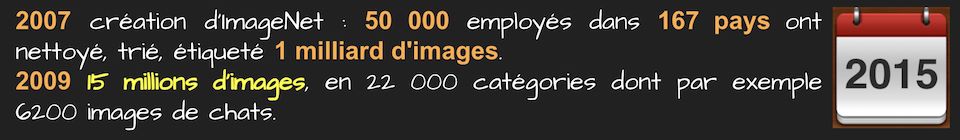
Mais avant d'aspirer tout le web, cela a commencé bien plus modestement.
How we teach computers to understand pictures | Fei Fei Li
Quand un tout jeune enfant regarde une photo, il peut identifier des éléments simples : un chat, un livre, une chaise. Aujourd'hui, les ordinateurs sont assez intelligents pour faire la même chose. Et après ? Dans cette passionnante conférence, la spécialiste en vision par ordinateur Fei-Fei Li décrit où nous en sommes : la base de données de 15 millions de photos mise en place par son équipe pour « enseigner » à un ordinateur à comprendre des photos, et un aperçu de ce qui reste encore à faire.
Les images/vidéos avec l'IA : comment ça marche ?
Modèles de diffusion, CLIP et les mathématiques qui permettent de transformer du texte en images.
Surgemini.google.com/appcopiez-collez le prompt suivant

Êtes-vous un robot ?
Cette phrase, vous la voyez assez régulièrement, accompagnée d'un CAPTCHA ou “Completely Automated Public Turing test to tell Computers and Humans Apart”, autrement une variante de tests de Turing permettant de différencier de manière automatisée un utilisateur humain d'un ordinateur. Ce test de défi-réponse est utilisé en informatique pour vérifier que l'utilisateur n'est pas un robot.
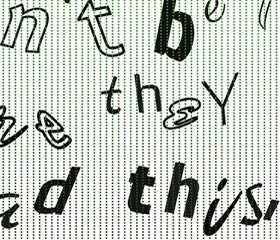 Dans
la
première version, l'on vous
demandait de reconnaître des lettres. Sauf que très vite les robots les reconnaissaient
aussi.
Sont alors arrivées les photos de rues et de feu rouges.
Notons ici que vous travaillez gratuitement pour enrichir la base de connaissance des IA, notamment en matière de conduite automobile en résolvant des problèmes difficiles à résoudre pour un robot. Du "machine learning" à votre insu.
Combien de cases de passages piétons auriez-vous coché ?
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
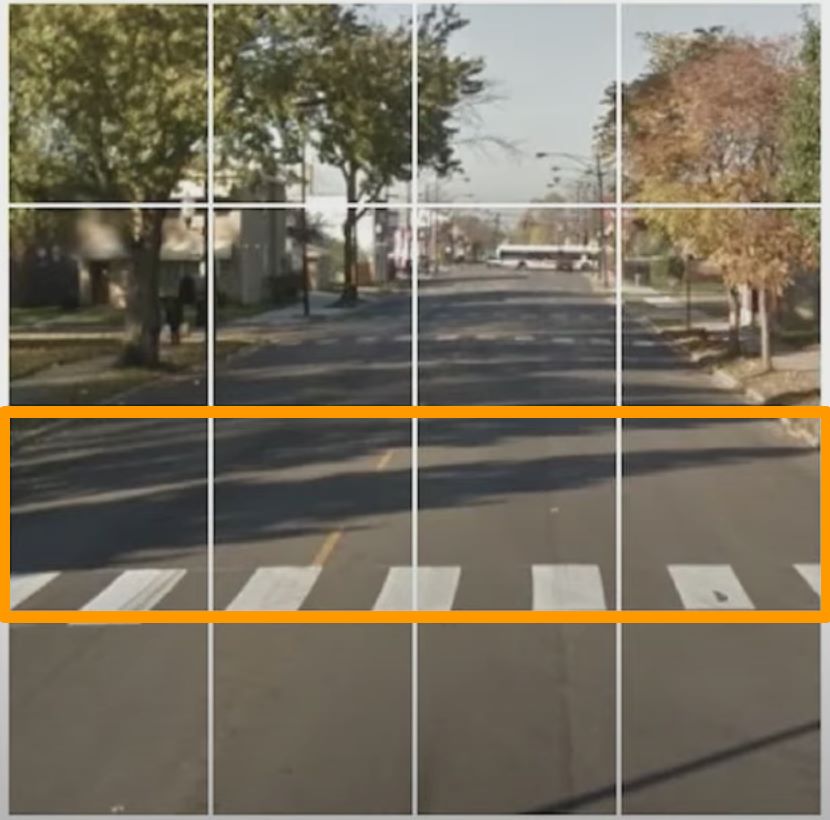
Mais vous auriez aussi très bien pu cocher 9 ou 10 cases, ce qui serait plus conforme à la réalité.
Bravo ! Vous n'êtes pas un 🤖 !
 Ce
CAPTCHA tend à disparaître au profit
d'une simple case à cocher. Simple, n'est pas ici exactement le mot, puisque que c'est
la
manière même (temps, déplacement de la souris etc.) qui va déterminer si vous êtes un
humain.
Ce dernier type de vérification va d'ailleurs aussi être remplacé par une analyse de comportement face à l'écran.
Ce sera la fin du CAPTCHA.

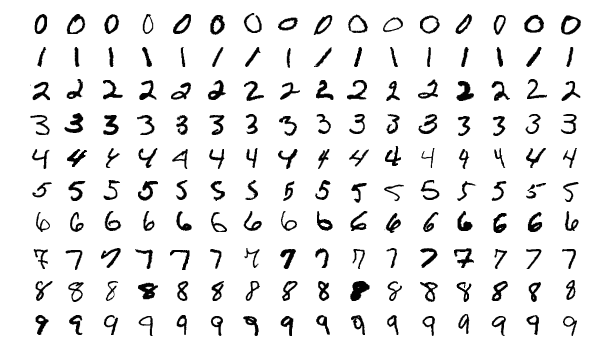 La
base de
données MNIST pour "Modified ou Mixed National Institute of Standards and
Technology",
est
une base de données de chiffres écrits à la main. C'est un jeu de données très
utilisé
en
apprentissage automatique.
La reconnaissance de l'écriture manuscrite est un problème difficile, et un bon test pour les algorithmes d'apprentissage. La base MNIST est devenue un test standard. Elle regroupe 60 000 images d'apprentissage et 10000 images de test.
Échec and Go
Longtemps l'enjeu pour l'IA a été de battre un joueur d'échec.
Sauf qu'aucun ordinateur, même à ce jour, ne sait calculer tous les coups et choisir le meilleur.
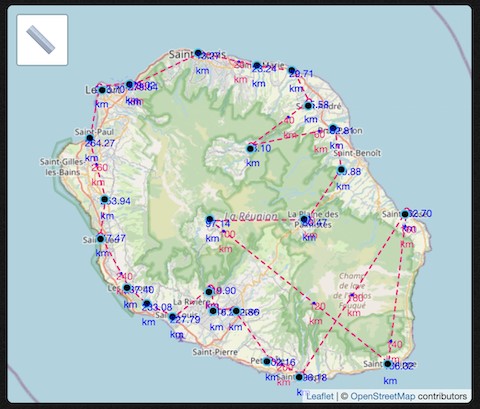
Contrairement à une idée généralement retenue, un ordinateur ne calcule pas tous les coups possibles mais prend des raccourcis, les algorithmes, qui lui permettent d'être plus efficace.
Par exemple ce jeu simple qui consiste à relier les villes en faisant le plus court chemin représente un nombre de combinaisons possibles qu'aucun ordinateur, même quantique et même en y mettant des millions d'années, ne saurait calculer.
Et cela parce que le nombre de combinaisons possibles est sidérant.
Voici ce chiffre :
Si ce chiffre exprimait des secondes, cela représenterait 410 millions d'années, un peu long pour calculer un trajet pour quelques villes.
Le problème du voyageur de commerce est l’un des problèmes les plus célèbres de la théorie des graphes. Il est étudié depuis plus de 150 ans et reste un sujet majeur en mathématiques.
Pourquoi est-il si difficile ?
On ne connaît aujourd’hui aucun algorithme capable de garantir la meilleure solution en un temps de calcul raisonnable lorsque le nombre de villes devient très grand.
Pourtant, on le résout tous les jours.
Si quelqu’un démontrait que P = NP (ou au contraire que P ≠ NP), cela résoudrait un des plus
grands problèmes ouverts de
l’informatique théorique.
Cette question fait partie des sept problèmes du prix du millénaire de l’Clay Mathematics
Institute. Chacun est doté d’une récompense de 1 million de dollars.
Et pour le jeu d'échec, quel est le nombre de coups possibles ?
Et pourtant c'est bien l'ordinateur qui a gagné, y compris au jeu de Go.
Le fonctionnement d’une intelligence artificielle
Une intelligence artificielle ou IA, peut faire plein de choses, mais concrètement
comment une IA fonctionne-t-elle ?
Découvrez à travers l'exemple du jeu de
stratégie, le Go, comment une intelligence artificielle peut être programmée pour
jouer
à ce jeu aux milliards de configurations différentes. Machine learning, deep
learning et
apprentissage par renforcement n'auront plus de secrets pour vous ! Une
animation-vidéo
co-réalisée avec L'Esprit Sorcier.
Nombre de coups d'avance
Un PC standard peut calculer de 10 à 100 millions de positions par seconde soit 20 à 25 coups et c'est tout.
Mais c'est aussi très largement suffisant au quotidien.
Les joueurs en ligne
 Si
l'IA a
connu ce développement c'est grâce à un seul acteur, Nvdia, le célèbre fabriquant de
cartes
graphiques. Nvidia récolte ainsi les fruits d’une vision de l’informatique “accélérée”,
couplant
les CPU avec des GPU pour contourner les limites de la loi de Moore.
La petite entreprise californienne créée avec 40 000 dollars vaut désormais plus de 1000 milliards.
Contrairement au CPU qui exécute les instructions des programmes informatiques, le GPU créé par Nvidia se concentre sur le calcul des visuels et leur rendu.
Le groupe américain historiquement dédié aux jeux vidéo envahi désormais les data centers, qui représentent désormais plus des trois quarts de son activité et 80% du marché global de l'IA.
 L’IA
générative requière une
immense puissance de calcul pour son entraînement ou son fonctionnement. Ce sont
donc des
processeurs Nvidia qu'utilise OpenAI pour donner vie aux requêtes des utilisateurs
de
ChatGPT.
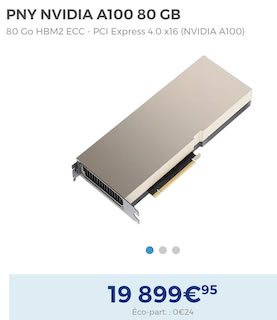
Microsoft détient ainsi plus de 10.000 cartes graphiques Nvidia A100.
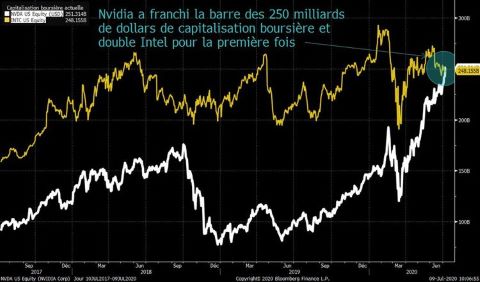
Résultat. Pour la première fois Nvidia passe devant Intel en capitalisation boursière.
En résumé, l’IA préfère les cartes graphiques (GPU) aux "gros ordinateurs" classiques (avec CPU) :
- Parce qu’un GPU fait plein de petits calculs en parallèle.
Un CPU (processeur central) est très bon pour exécuter quelques tâches complexes à la fois, avec beaucoup de logique. Un GPU (processeur graphique), lui, est conçu pour faire des milliers de calculs simples en même temps (à l’origine : pour les pixels !). Le deep learning repose sur des millions de multiplications de matrices. - Parce qu’un modèle d’IA, c’est du sport intensif.
Entraîner un modèle IA, ce sont des milliards de paramètres à ajuster. Les GPU sont taillés pour cette charge : des calculs massifs, répétitifs, et en rafale. Un CPU, même très puissant, serait vite débordé (ou très, très lent). - Parce que c’est beaucoup plus rapide (et rentable).
Entraîner un modèle sur un CPU prendrait des siècles. Sur un ensemble de GPU (ou des TPU, encore plus spécialisés), cela prend quelques semaines. Et le temps, c’est… de l’énergie et de l’argent.
Nous avons ainsi les 3 ingrédients qui ont rendus le succès mondial possible :
- La technologie des réseaux de neurones
- Des données en masse
- Une puissance de calcul
Les IA génératives de textes
Le cas ChatGPT
ChatGPT est un robot conversationnel qui permet de répondre aux questions que vous lui posez. L’accès aux anciennes versions est gratuit.
Pour y accéder, il suffit de se rendre sur le site officiel de ChatGPT d’OpenAI, et s’inscrire.
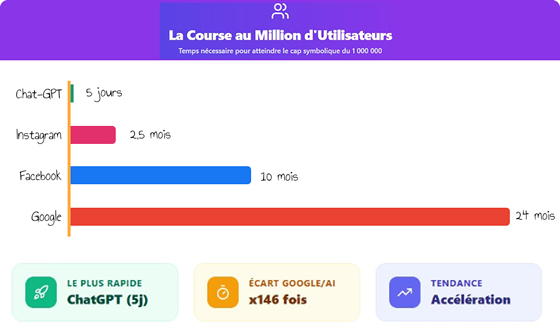
Ce qui a été particulièrement marquant, et cela alors même que l'IA existe depuis des dizaines d'années, c'est la rapidité d'adoption par le public.
Voici le temps mis par Chat-GPT pour atteindre
1 million
d'utilisateurs.
Qu'est-ce que GPT ?
GPT signifie Generative Pre-trained Transformer. C’est une architecture de réseau de neurones créée par OpenAI.
- Generative : Il génère du texte.
- Pre-trained : Il a été entraîné sur d'énormes quantités de données avant qu'on ne l'utilise.
- Transformer : C'est le type de technologie (inventée par Google en 2017) qui permet au modèle de comprendre les relations entre les mots dans une phrase.
Mais avant ce raz-de-marée il y a eu plusieurs versions GPT : GPT-1 (2018), GPT-2 (2019), GPT-3 (2020) etc.
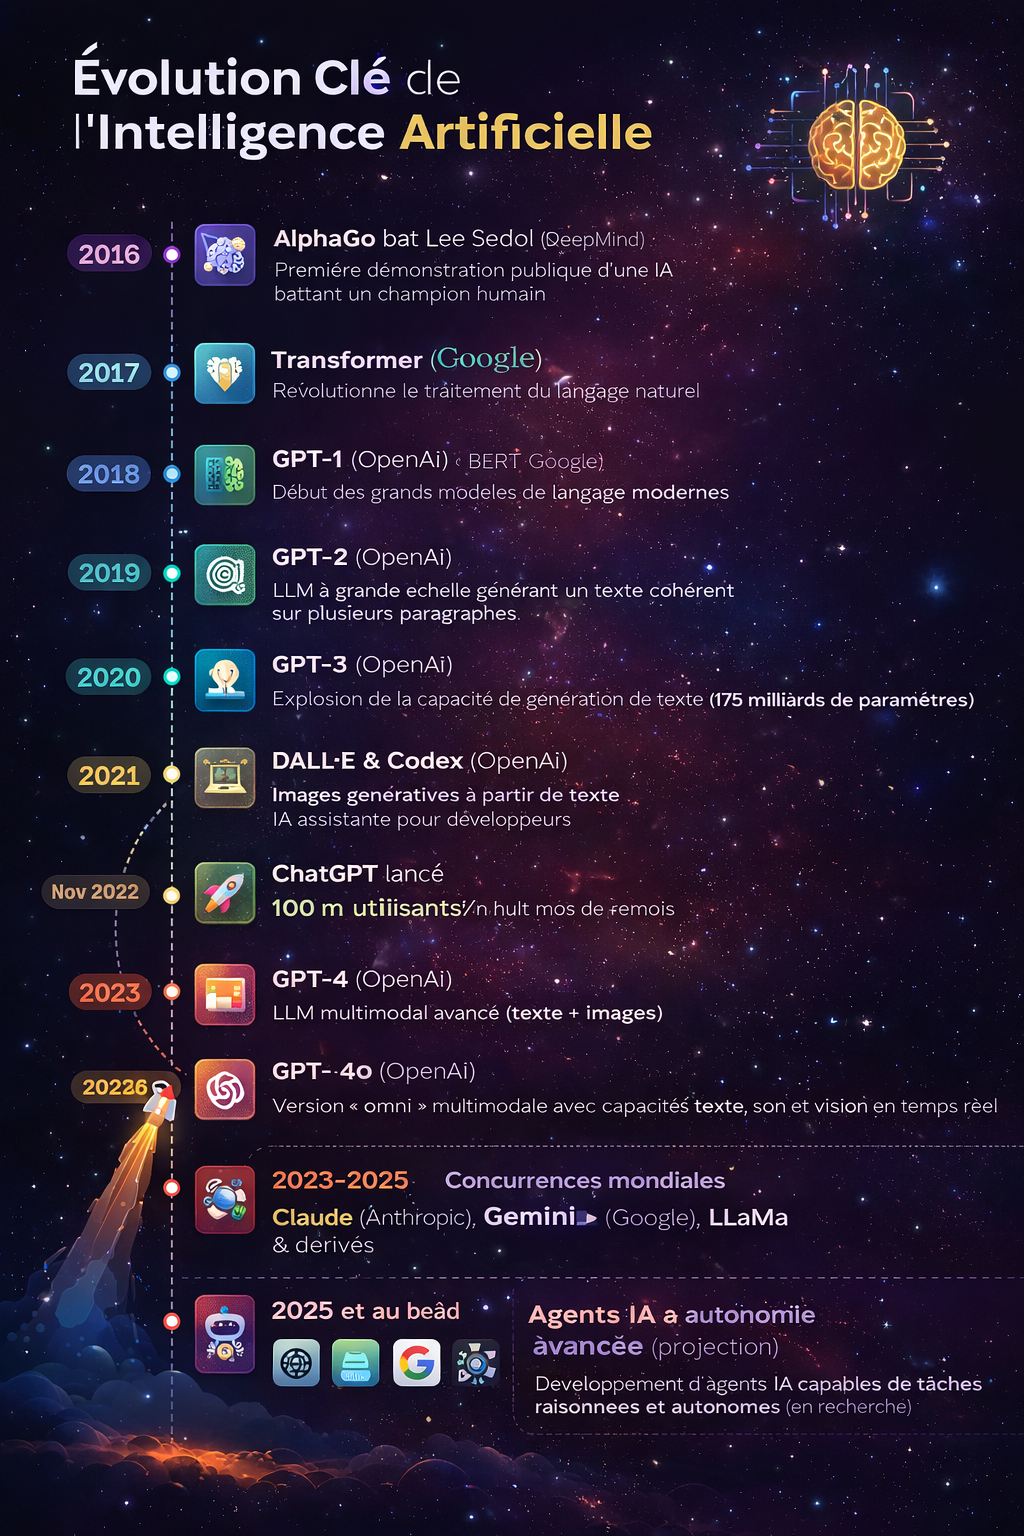


ChatGPT est une intelligence artificielle dite conversationnelle, un chatbot basé sur GPT (Generative Pre-training Transformer).
Il peut être utilisé pour effectuer diverses tâches comme :
- La génération de texte (y compris par exemple lettre de motivation, réponse à un mail, poème, scénario etc.)
- La traduction
- La compréhension de questions
- La transformation de données en tableaux
- La génération de code
- La génération et la modification d'images
- …
Quelles alternatives à ChatGPT ?


Les IA Qui ne nécesitent pas de comptes


 /

Les IA françaises
La France a commencé à bâtir son propre ChatGpt depuis l'été 2021. Avec Bloom, un projet de science ouverte et participative piloté par Hugging Face, une start-up fondée à New-York… par trois Français.
Cette intelligence artificielle a été mise au point par un millier de chercheurs, avec le soutien du CNRS, du ministère de l'enseignement supérieur et de la recherche ainsi que de partenaires du domaine privé, des entreprises comme Thalès, Airbus ou Orange.
Ce chatbot, capable de s'exprimer en 46 langues, s'appuie une technologie comparable à ChatGPT et s'entraîne sur le supercalculateur Jean-Zay, le plus puissant d'Europe, basé à Saclay.


Les IA chinoises

Focus sur Copilot
Copilot est un assistant personnel proposé par Microsoft, et qui peut générer des images à partir de descriptions textuelles.
Il existe une version pro, intégrée à office pour proposer des textes.


 copilot.microsoft.com/
5 alternatives open source
Jeune à 60 ans
 L’IA
est en réalité une discipline
jeune d’une soixante d’années, qui réunit des sciences, théories et techniques
— notamment logique mathématique, statistiques, probabilités, neurobiologie computationnelle et
informatique — et dont le but est de parvenir à faire imiter par une machine les capacités
cognitives humaines.
Elle a connu des hauts et des bas, les fameux hivers de l'IA⛄ et a même longtemps été la risée des traducteurs — « My tailor is rich » — avant de se mettre progressivement à « marcher ».
Mais elle n’aurait pas pu devenir ce qu’elle est aujourd’hui sans une autre histoire : celle de l’accès à l’information.
Avant le Web, il y avait les fiches. Puis les bases documentaires, les catalogues, les moteurs de recherche et l’immense masse de données du Web.
Car pour qu'une machine puisse apprendre, encore faut-il qu'elle ait quelque chose à apprendre. Et pour qu'elle puisse retrouver, comparer et mettre en relation des informations, il faut d'abord que ces informations soient organisées, indexées et accessibles.
Cédric Villani
L’intelligence artificielle est une révolution technologique. Elle génère enthousiasmes, inquiétudes et fantasmes. Mais comment est-elle née ? Le scientifique Cédric Villani, qui a rédigé un rapport parlementaire sur l'IA, éclaire l'histoire si récente de ce bouleversement technologique. 4 épisodes des 12 minutes.
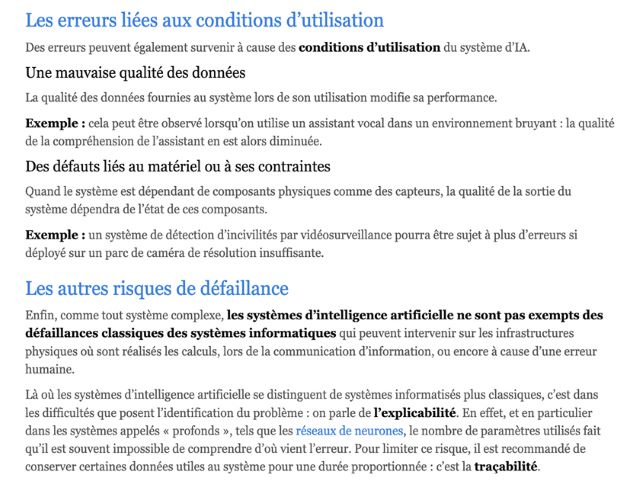
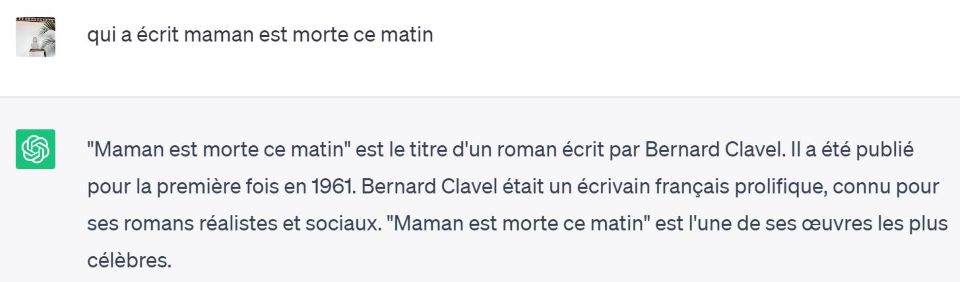
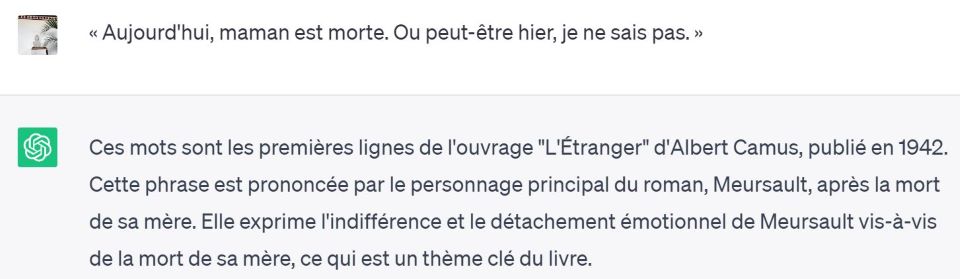
Pourquoi une IA fait-elle des erreurs ?
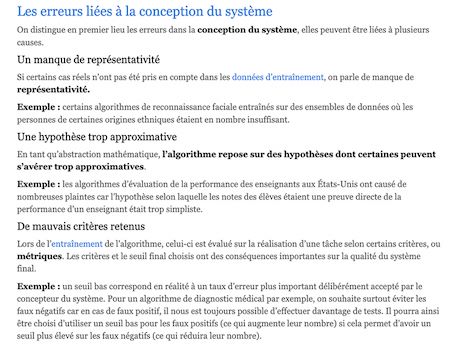
Étant donné la complexité des systèmes utilisant l’intelligence artificielle, les sources d’erreur peuvent être multiples.
L'IA est en train de s'empoisonner ?
Que se passe t’il si un modèle d’intelligence artificielle (IA) générative s’entraine sur une proportion de plus en plus importante d’images auto-générées ? C'est à cette question que Quentin Bertrand, chargé de recherche au centre Inria de Lyon et membre de l’équipe-projet Malice a tenté de répondre.
Qu'est-ce que l'effondrement des modèles ?
L'effondrement des modèles est un processus dégénératif qui affecte les générations successives de modèles génératifs appris, dans lequel les données qu'ils génèrent finissent par polluer l'ensemble d'entraînement de la génération suivante, les conduisant à mal percevoir la réalité.
Causes principales :
- Erreur d'approximation statistique (échantillons finis)
- Erreur d'expressivité fonctionnelle (limitations des réseaux de neurones)
- Erreur d'approximation fonctionnelle (limitations des procédures d'apprentissage)
Pour maintenir l'apprentissage sur le long terme, il est nécessaire de préserver l'accès aux sources de données originales et de s'assurer que des données non générées par des LLM restent disponibles dans le temps. Les événements à faible probabilité, souvent pertinents pour les groupes marginalisés, sont particulièrement menacés par ce phénomène.
L'IA est en train de s'empoisonner ?
L'IA est-elle en train de s'empoisonner elle-même ?
Interview de Loubna Ben Allal chercheuse chez HuffingFace.
Un ordinateur est-il fiable ?
Outre les possibles erreurs de calcul liées à de sombres histoires de virgules flottantes, se posent également les problèmes de fuites ou de saturation de mémoire. Les fuites de mémoire se produisent lorsque les programmes ne parviennent pas à libérer les ressources mémoire dont ils n’ont plus besoin. Cela se traduit par des problèmes de performances. En termes simples, votre ordinateur manque de mémoire.
Un exemple
Le nombre maximum de lignes qu'un tableur Excel peut afficher et d'à peine un peu plus d'un million, plus exactement 1 048 576 lignes et 16 384 colonnes. Un tout petit nombre comparé aux données traitées par l'IA.
Notons ici également qu'un tableur, comme tout ordinateur, fait des erreurs. Et des erreurs non pas par erreur mais par sa programmation même.
Testons un calcul simple :1 + 0.000123456789012345
Ce calcul qu'un élève de CM2 saurait faire, un tableur de type Excel ou OpenOffice le fait-il ?
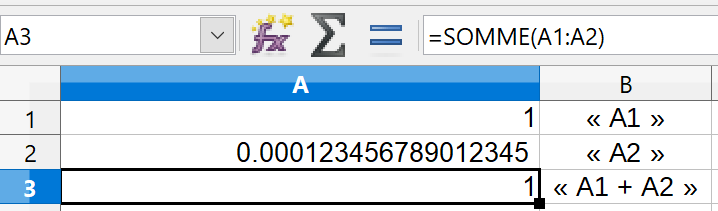
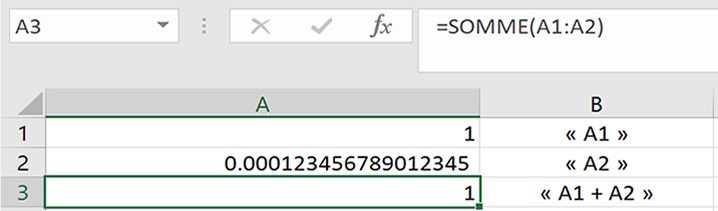
Dans le même ordre d'idées, un calcul de type 0.1 + 0.2, au lieu d'obtenir un 0.3 parfait, donne quelquefois un résultat comme 0.30000000000000004.
Ou encore, calculer 1/824633702441.0.
Simple me direz-vous !
Et pourtant une
erreur de
division à virgule flottante dans ses processeurs Pentium a entraîné leur remplacement.
Prix
de
l’erreur : 475 millions de dollars.